La tua azienda pubblica una guida utile. Vuoi che i clienti la trovino su Google, ne chiedano informazioni a ChatGPT e seguano un link al tuo sito. Ma potresti non volere che quella stessa guida venga usata per addestrare il prossimo modello di IA.
Puoi scegliere una cosa senza accettare anche l’altra?
A volte. La risposta dipende dal fornitore, dal prodotto e dal controllo utilizzato. Alcune aziende separano l’addestramento dalla ricerca. Altre lo associano a usi che aiutano anche le persone a scoprire i tuoi contenuti. Un’impostazione generica per «bloccare l’IA» può quindi eliminare opportunità che volevi conservare.
Per chi gestisce un sito, questo è un aspetto pratico della generative engine optimisation, o GEO: capire come i contenuti diventano disponibili ai servizi di IA e decidere quali usi favoriscono la propria attività.
Documentazione dei fornitori verificata il 1° ottobre 2026. Ricontrolla le indicazioni collegate prima di modificare un sito in produzione.
In questa guida
1. Una pagina può servire a quattro scopi diversi
Prima di cambiare un’impostazione, distingui gli usi che vuoi controllare.
Addestramento: aiuta a sviluppare o migliorare un modello. Ricerca: aiuta un servizio a scoprire e indicizzare le pagine, così che possano essere trovate in seguito. Grounding: fornisce informazioni durante la stesura di una risposta. Recupero su richiesta dell’utente: avviene quando qualcuno chiede a un assistente di aprire una pagina specifica.
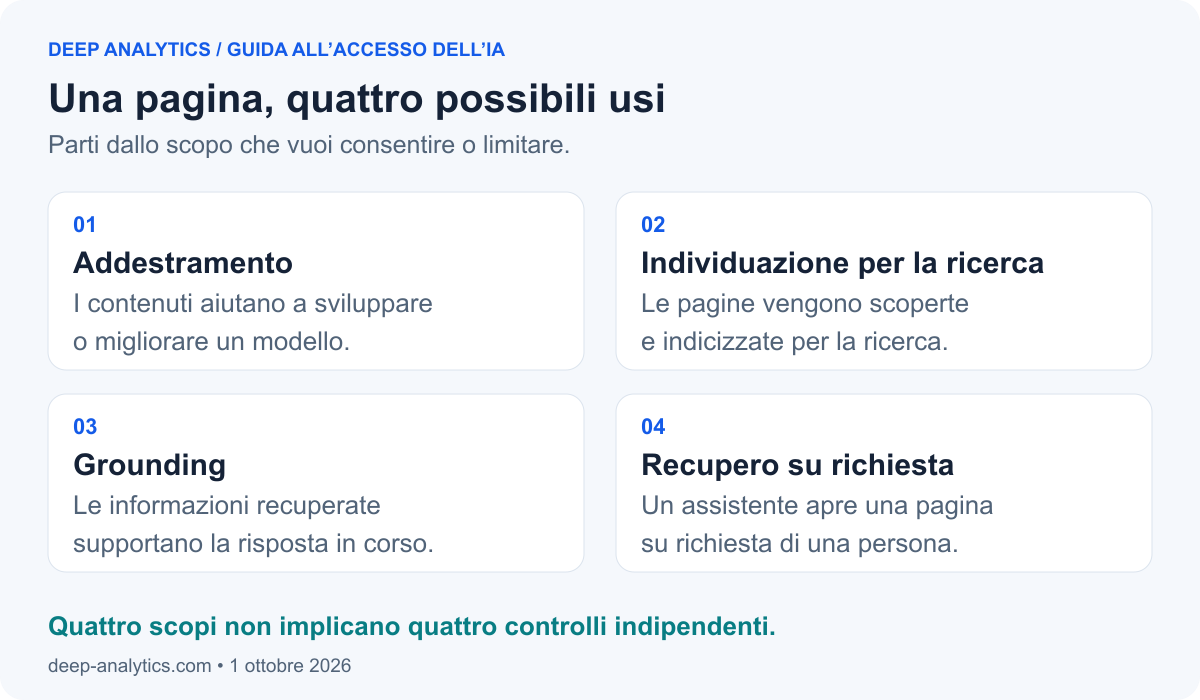
Sono quattro scopi. Non corrispondono necessariamente a quattro crawler distinti o a quattro impostazioni indipendenti.
Immagina che un cliente chieda a un assistente se la tua società di consulenza opera in Italia. Per rispondere, l’assistente potrebbe recuperare la pagina attuale dei tuoi servizi. È una cosa diversa dal contributo che la pagina potrebbe aver dato al precedente sviluppo del modello.
Questa distinzione spiega perché «voglio bloccare l’IA» è un’istruzione incompleta. Una politica più utile è: «Manteniamo le pagine pubbliche disponibili per la ricerca e le richieste dei clienti; limitiamo gli usi di addestramento per i quali esistono controlli». Resta da capire quali fornitori consentano questa scelta senza rinunciare ad altro.
Le modalità variano da un fornitore all’altro. La documentazione sui crawler di Anthropic e la spiegazione del grounding di Google illustrano queste differenze.
2. Dove si configurano i controlli
Un crawler è un software che richiede pagine web automaticamente. Il sito può comunicargli istruzioni in diversi punti, mentre il servizio di sicurezza può decidere se lasciar passare la richiesta.
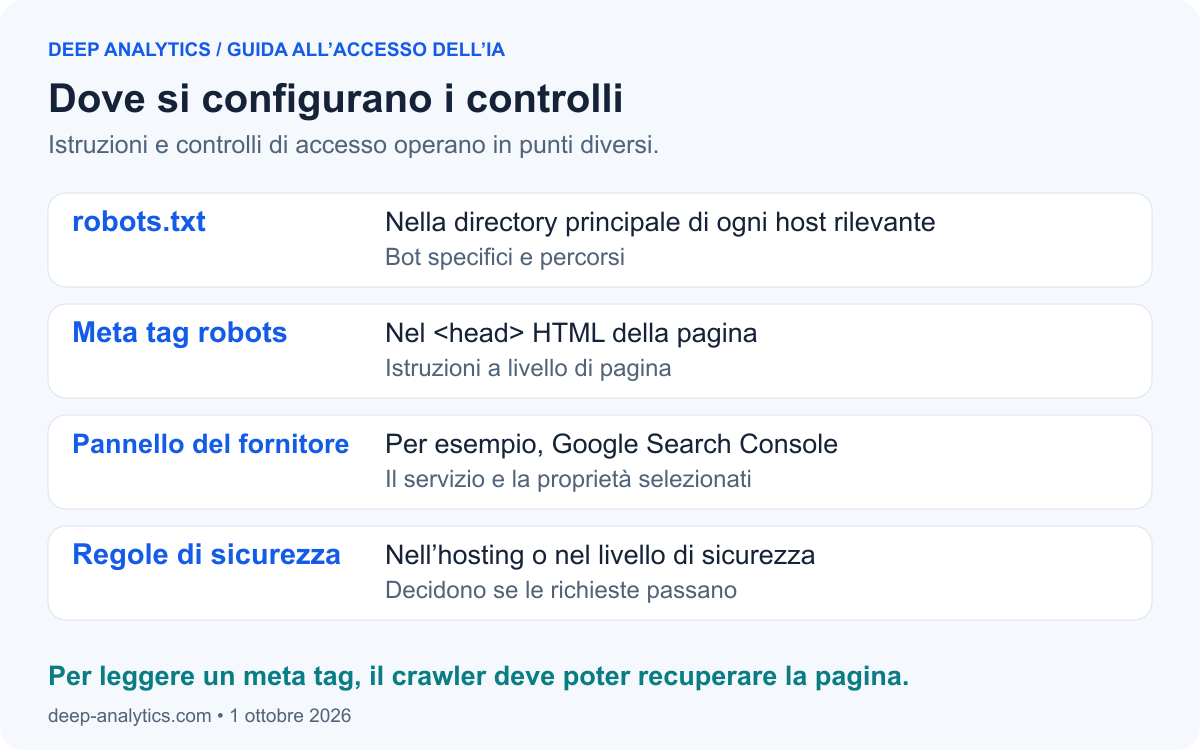
Robots.txt è un file di testo nella radice di un sito, ad esempio https://example.com/robots.txt. Le sue regole si riferiscono a bot identificati per nome e a percorsi del sito. Esamina ogni host pertinente: una regola sul dominio principale non esprime automaticamente la stessa politica per tutti i sottodomini.
Un meta tag robots va inserito nell’elemento HTML <head> della pagina, dove si trovano i metadati. È diverso dall’intestazione visibile o dalla navigazione. Incollare un tag nel testo dell’articolo non lo configura. Il tag può essere generato da un modello di pagina o da un’impostazione SEO del sistema di gestione dei contenuti.
Le impostazioni del pannello si applicano all’interno del servizio di un fornitore, come Google Search Console. Le regole del firewall agiscono nel livello di sicurezza attraversato dalle richieste. Questi controlli devono essere coerenti con la politica che intendi applicare.
Ricorda: un crawler deve recuperare la pagina per leggere un meta tag al suo interno. Bloccare quella richiesta può impedirgli di vedere l’istruzione.
Fonti: posizione e ambito di robots.txt e metadati delle pagine e accesso dei crawler.
3. Confronta i controlli dei fornitori
Parti dai servizi usati dai tuoi clienti. Il nome di un crawler indica a chi applicare una regola; la documentazione del fornitore spiega che cosa cambia davvero con quella regola.
OpenAI e Anthropic: scelte separate per addestramento e ricerca
OpenAI, l’azienda che sviluppa ChatGPT, distingue GPTBot, per la raccolta di contenuti potenzialmente destinati all’addestramento, da OAI-SearchBot, per la ricerca. Le rispettive impostazioni in robots.txt sono indipendenti. Anthropic, l’azienda che sviluppa Claude, separa ClaudeBot da Claude-SearchBot in modo simile.
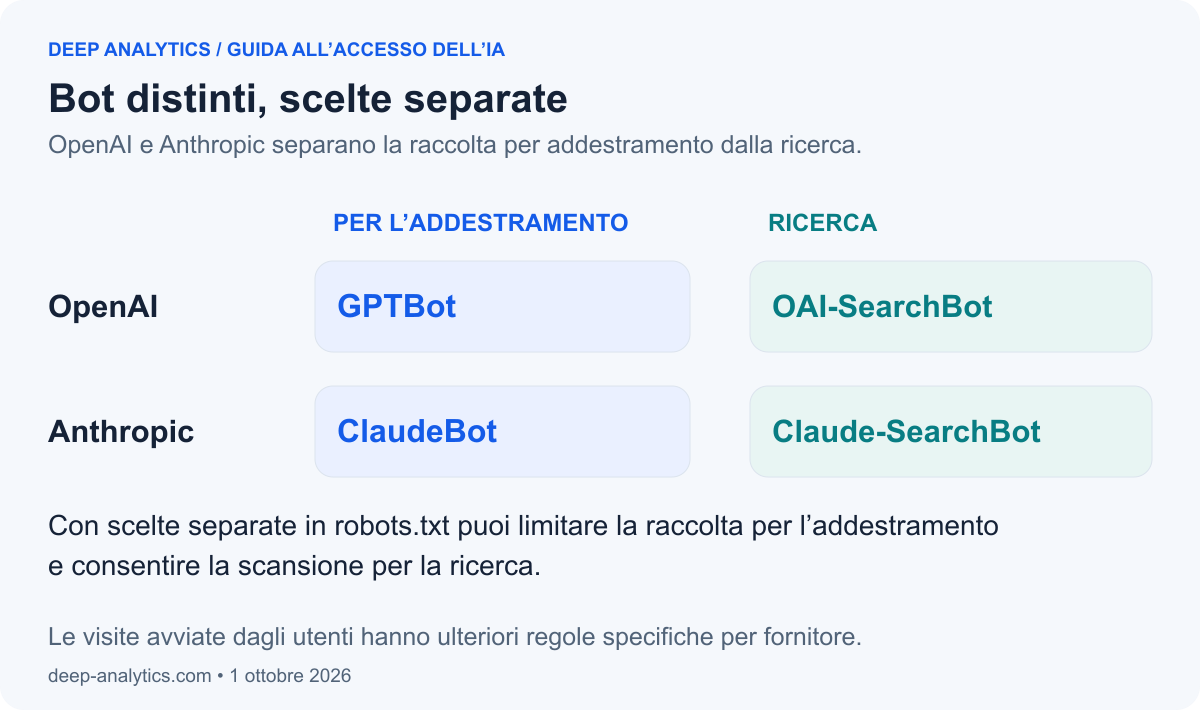
Per le visite richieste dagli utenti, le regole cambiano. Anthropic afferma che Claude-User rispetta robots.txt. OpenAI afferma che robots.txt potrebbe non applicarsi ad alcune richieste effettuate tramite ChatGPT-User. Consentire un crawler di ricerca rende possibile l’accesso; non garantisce una citazione.
Fonti: documentazione sui crawler di OpenAI e documentazione sui crawler di Anthropic.
Altri fornitori da includere nell’audit
- Perplexity:
PerplexityBotsupporta la ricerca e non viene usato per raccogliere contenuti destinati all’addestramento dei modelli di base.Perplexity-Userrecupera pagine per gli utenti e generalmente ignora robots.txt. Verifica sia l’accesso dei crawler sia le impostazioni del firewall. Consulta le indicazioni sui crawler di Perplexity. - Apple:
Applebotsupporta la ricerca.Applebot-Extendedè un token di controllo dell’addestramento in robots.txt, non un crawler distinto; vietarlo mantiene la possibilità di comparire nella ricerca. Il controllonosnippetdi Apple limita anche l’uso nelle risposte dell’IA: consideralo quindi una decisione separata sulla visibilità. Consulta la documentazione di Apple. - Amazon:
Amzn-SearchBotsupporta la ricerca senza raccogliere contenuti per l’addestramento;Amzn-Userrecupera informazioni per gli utenti e potrebbe non seguire tutte le direttive di robots.txt.Amazonbotha usi più ampi per il miglioramento dei prodotti, che possono includere l’addestramento. Amazon documenta anchenoarchivea livello di pagina come restrizione all’addestramento. Consulta le indicazioni sui crawler di Amazon. - Meta:
Meta-WebIndexersupporta la ricerca di Meta AI.Meta-ExternalAgentriguarda l’addestramento e l’indicizzazione diretta, quindi bloccarlo incide su entrambi gli usi documentati.Meta-ExternalFetchergestisce le richieste degli utenti e altre funzioni legate agli agenti e può ignorare robots.txt. Consulta la documentazione sui crawler di Meta. - Common Crawl:
CCBotraccoglie un dataset aperto del web che altri possono riutilizzare. Limitarlo riguarda la raccolta in quel dataset, non un servizio dedicato esclusivamente all’addestramento né un’esclusione universale dagli usi successivi. Consulta la panoramica del dataset di Common Crawl e le indicazioni per identificare il crawler.
Google e Microsoft richiedono maggiore attenzione perché i loro controlli comportano ulteriori compromessi. Li esaminiamo nelle prossime due sezioni.
Un esempio commentato di robots.txt da adattare
Questo estratto illustra restrizioni separate all’addestramento per OpenAI, Anthropic e Apple, consentendo al contempo ai crawler di ricerca indicati di accedere alle pagine pubbliche. Adattalo alla configurazione esistente. Non sostituisce il file robots.txt completo del sito.
# Restrizioni all’addestramento per questi tre fornitori
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Applebot-Extended
Disallow: /

# Crawler di ricerca: le pagine pubbliche restano accessibili alla scansione
# /admin/ è un percorso di ESEMPIO: mantieni le restrizioni reali.
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
User-agent: Amzn-SearchBot
User-agent: Meta-WebIndexer
User-agent: Googlebot
User-agent: Bingbot
User-agent: Applebot
Disallow: /admin/

# Gruppo predefinito per i bot senza un gruppo più specifico
# Mantieni tutte le regole applicabili del file esistente.
User-agent: *
Disallow: /admin/
User-agent identifica il crawler o il token di controllo. Più nomi possono condividere lo stesso gruppo. Disallow: / si applica a tutti i percorsi; /admin/ si applica solo a quella cartella di esempio. Con le regole mostrate, gli altri percorsi restano consentiti.
I gruppi con nomi specifici non ereditano le restrizioni del gruppo con carattere jolly. Integra con attenzione le regole esistenti e ripeti le restrizioni sui percorsi pertinenti in ogni gruppo specifico. In questo esempio i sistemi che recuperano pagine su richiesta dell’utente restano nel gruppo predefinito; continuano comunque ad applicarsi le eccezioni dei rispettivi fornitori. Il Robots Exclusion Protocol spiega come avviene la corrispondenza con i gruppi.
L’esempio lascia volutamente Google-Extended, Amazonbot, Meta-ExternalAgent e CCBot a decisioni separate. Inoltre, non esprime la restrizione all’addestramento di Microsoft. Valuta le implicazioni prima di aggiungere regole. I contenuti privati richiedono comunque l’autenticazione: robots.txt è leggibile pubblicamente e non è una barriera di sicurezza.
4. Google richiede tre verifiche
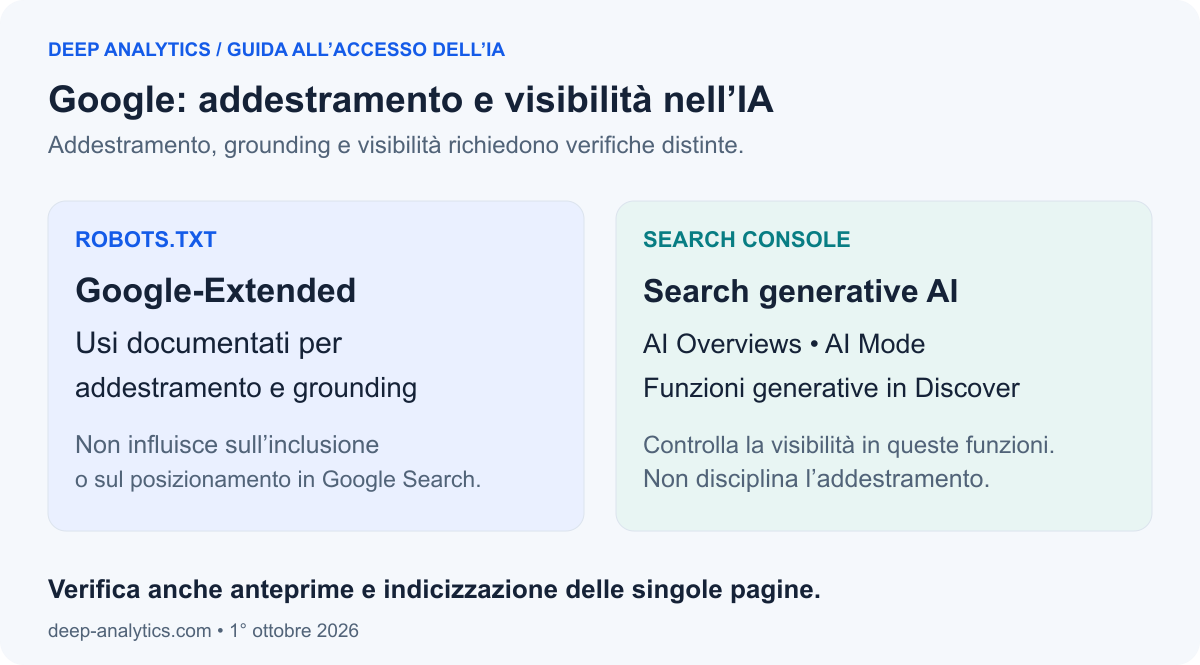
I controlli di Google operano a livelli diversi: usi consentiti dei modelli, inclusione nelle funzioni di ricerca con IA e contenuti che le singole pagine possono mostrare. Verifica tutti e tre prima di concludere che il sito sia configurato correttamente.
Verifica 1: Google-Extended riguarda l’addestramento e alcuni usi di grounding
Google-Extended è un token di controllo in robots.txt, non il nome di un crawler HTTP distinto da cercare nei log del server. Il suo ambito documentato comprende l’addestramento di Gemini e il grounding in Gemini Apps e Vertex AI, la piattaforma di Google per creare applicazioni di IA. Bloccarlo limita anche questi usi di grounding; non influisce sull’inclusione o sul posizionamento in Google Search.
Definirlo un interruttore per il solo addestramento nasconderebbe questo compromesso. Consulta la documentazione sui crawler di Google.
Verifica 2: Search Console controlla l’inclusione nella ricerca con IA
Search Console è lo strumento di Google per chi gestisce siti web. In Settings → Search generative AI, i proprietari possono gestire l’inclusione in AI Overviews, AI Mode e nelle funzioni generative di Discover. Google afferma che questo controllo è disponibile in tutto il mondo dal 31 agosto 2026.
Escludere una proprietà rimuove i suoi contenuti e link da queste funzioni senza modificare l’inclusione o il posizionamento nelle altre parti di Search. Verifica se eredita la scelta di una proprietà superiore. Questa impostazione non controlla l’addestramento: la guida di Google rimanda a Google-Extended per le restrizioni all’addestramento dei modelli usati in queste funzioni. Consulta la guida di Search Console.
Verifica 3: anteprime e indicizzazione a livello di pagina
L’accesso di Googlebot alla scansione e le istruzioni delle pagine restano importanti. I controlli seguenti hanno effetti diversi:
data-nosnippetesclude i passaggi selezionati dagli snippet; applicalo a un elemento<span>,<div>o<section>che racchiude il testo interessato.max-snippetlimita il testo disponibile per le anteprime. Non è un’esclusione generale dall’addestramento né una garanzia che una funzione di IA scompaia.nosnippetimpedisce gli snippet di testo e limita l’uso diretto come input per AI Overviews e AI Mode.noindexrimuove la pagina da Google Search una volta elaborato. Sacrifica la visibilità nella ricerca e non va usato soltanto per limitare l’addestramento.
I meta tag robots validi per l’intera pagina vanno nell’elemento HTML <head>. Bloccare Googlebot in robots.txt può impedirgli di vederli. Queste scelte possono influire anche sulla presentazione nei risultati di ricerca ordinari. Fonti: indicazioni di Google sulle funzioni di IA e specifiche dei metadati robots.
5. I tag Microsoft comportano un compromesso sulla visibilità
Bing è il motore di ricerca di Microsoft e il suo indice contribuisce ad alimentare le esperienze Copilot. La spiegazione originale di Microsoft risale al 2023, all’epoca di Bing Chat; l’attuale pagina di assistenza di Bing descrive i controlli per Chat e Copilot.
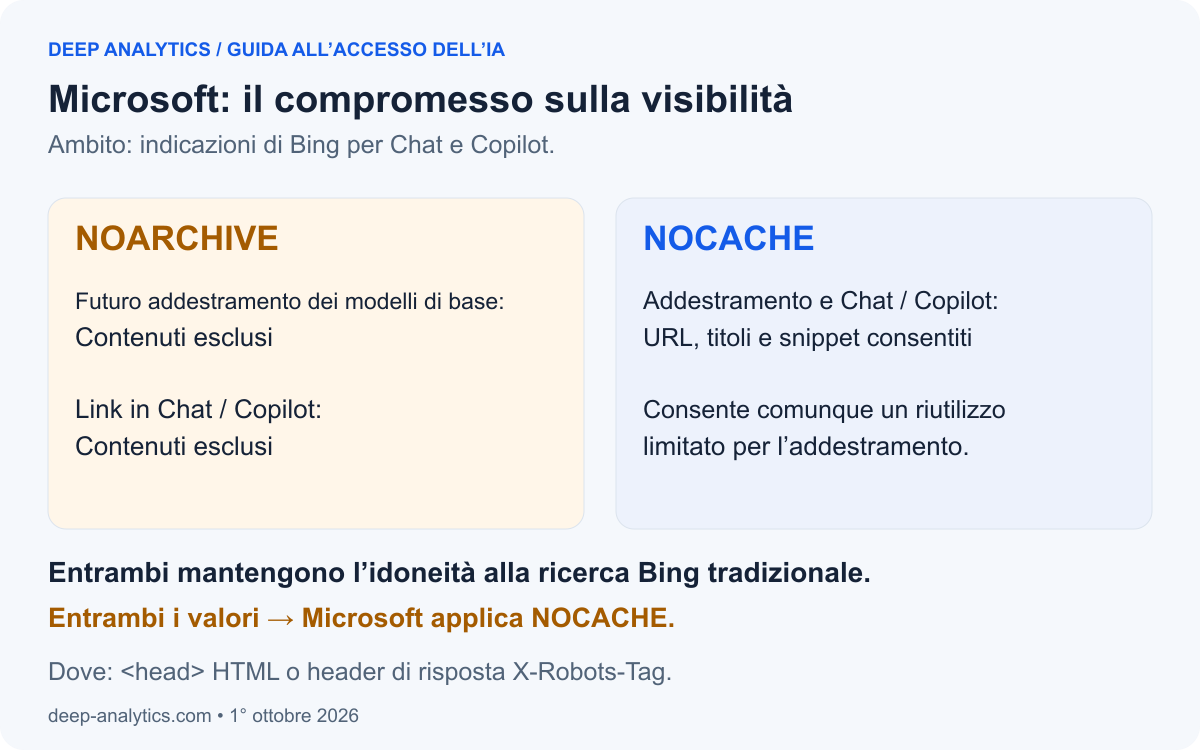
Per richiedere la politica NOARCHIVE per Bing, inserisci questo tag nell’elemento HTML <head> della pagina interessata:
<meta name="bingbot" content="noarchive">Questo limita l’addestramento dei modelli di base e sacrifica i link in Chat/Copilot. L’annuncio del 2023 spiega anche l’esclusione dalle risposte, pur mantenendo la possibilità di comparire nella ricerca Bing tradizionale.
L’alternativa è:
<meta name="bingbot" content="nocache">NOCACHE consente l’uso di URL, titoli e snippet in Chat/Copilot e nell’addestramento. Non è un’esclusione completa dall’addestramento. Se entrambi i valori sono presenti, Microsoft applica NOCACHE.
Per PDF e altri file: usa un header di risposta
Un PDF non ha un elemento HTML <head>. Configura il server web o la CDN affinché invii un header di risposta HTTP insieme al file, ad esempio:
X-Robots-Tag: bingbot: noarchiveSono metadati della risposta, non una riga da incollare nel PDF o in robots.txt. Bing supporta le proprie direttive robots tramite X-Robots-Tag; dopo averlo configurato, verifica l’header effettivamente inviato. Le indicazioni di Microsoft sugli header per i contenuti non HTML spiegano dove inserirlo.
Per l’HTML, name="robots" applica l’istruzione in modo più ampio; name="bingbot" la limita a Bing. Verifica le interpretazioni degli altri fornitori prima di ampliarne l’ambito. Usa il CMS o il modello che genera le pagine interessate e scegli deliberatamente una politica. NOCACHE in questo contesto è diverso dall’header HTTP Cache-Control usato per la cache dei browser e delle CDN.
6. Cloudflare può fermare un crawler prima che raggiunga la pagina
Cloudflare offre servizi per le prestazioni e la sicurezza dei siti web. Per il traffico che passa attraverso la sua rete, si colloca tra un visitatore o crawler e il server che ospita il sito. Può servire contenuti dalla cache e filtrare le richieste prima che raggiungano quel server. Come funziona Cloudflare
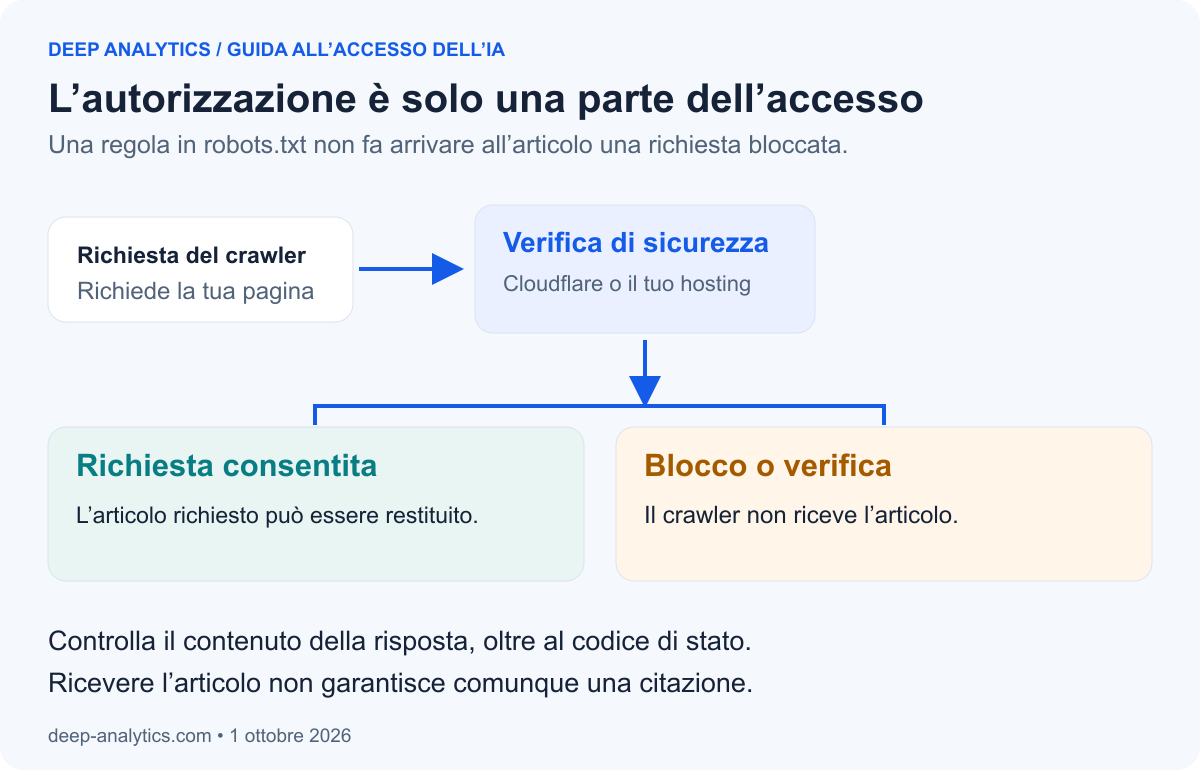
Questo lo rende parte della configurazione della visibilità nella ricerca. Una regola permissiva in robots.txt serve a poco nella pratica se il firewall restituisce un blocco o una schermata di verifica al posto dell’articolo.
Le modifiche di Cloudflare di settembre 2026 distinguono tre controlli:
- Search: scansione per costruire un indice di ricerca.
- Training: raccolta di contenuti per lo sviluppo dei modelli.
- Agent: visite per conto di un utente.
Con Disallow AI Training, Bot Preference Sync pubblica in robots.txt le preferenze di addestramento supportate. I crawler a uso misto che soddisfano i criteri restano consentiti per la ricerca; gli altri crawler di addestramento vengono bloccati attivamente. Un crawler a uso misto serve a più di uno scopo.
Block può fermare anche Googlebot, Bingbot e Applebot, incidendo sull’accesso per la ricerca. Cloudflare sta sostituendo i vecchi controlli e i precedenti blocchi Training vengono migrati a Disallow AI Training. Verifica anche l’impostazione Agent risultante: alcune configurazioni migrate e la preimpostazione per i siti finanziati dalla pubblicità bloccano gli agenti sulle pagine con annunci.
La preferenza di addestramento di Microsoft a livello di sito tramite robots.txt resta prevista per l’inizio del 2027. Finché non sarà disponibile, Disallow AI Training non comunica automaticamente quella preferenza a Bing tramite robots.txt; esamina separatamente i controlli di Microsoft nelle pagine o negli header.
Fonte: impostazioni, tabelle di migrazione e limiti dei fornitori descritti da Cloudflare.
Indicazione pratica: controlla sia il robots.txt effettivamente servito sia le regole di sicurezza. Un codice di stato HTTP di successo, da solo, non basta: una pagina di verifica non è l’articolo che il crawler voleva recuperare.
7. Come verificare gli effetti reali delle impostazioni
Parti da una decisione aziendale: quali usi aiutano i clienti a trovare e valutare la tua azienda, e quali vuoi limitare? Poi esegui queste cinque verifiche.
- Metti per iscritto la politica desiderata. Registra, per ogni fornitore, le scelte relative ad addestramento, ricerca, grounding e accesso su richiesta dell’utente. Annota dove i controlli disponibili raggruppano più usi.
- Trova tutte le impostazioni pertinenti. Esamina robots.txt, modelli di pagina, pannelli dei fornitori e regole di sicurezza. Includi i sottodomini importanti e le versioni linguistiche.
- Esamina ciò che il sito serve effettivamente. Controlla il file robots.txt pubblico e l’HTML delle pagine. Un’impostazione nell’editor documenta la tua intenzione; la risposta inviata mostra ciò che un crawler può ricevere.
- Verifica l’accesso dei crawler reali. Confronta i log del server o del servizio di sicurezza con gli intervalli IP ufficiali o con le verifiche DNS documentate dal fornitore. Copiare il nome di uno user agent è solo un test diagnostico: qualsiasi client può dichiarare quel nome.
- Misura separatamente i risultati. Monitora errori di scansione, indicizzazione, citazioni dell’IA su un campione, visite dai link di riferimento e richieste di contatto. Registra quando cambiano le impostazioni, così da poter indagare i risultati senza presumere che la coincidenza temporale dimostri un rapporto di causa ed effetto.
Rendi concreta la verifica dell’accesso
Per Perplexity, un’eccezione nel firewall dovrebbe richiedere la corrispondenza con sia lo user agent previsto sia un IP appartenente agli intervalli ufficiali pubblicati. Mantieni aggiornati questi intervalli e limita l’eccezione all’accesso previsto per il bot. Le indicazioni di Perplexity sul firewall spiegano l’approccio. Anche OpenAI, Amazon, Apple e Common Crawl documentano metodi di verifica nelle pagine dei fornitori collegate sopra.
Affianca i report ai tuoi dati analitici
Google offre un report Generative AI performance. Bing Webmaster Tools offre un report AI Performance che comprende le citazioni nelle esperienze Microsoft e dei partner supportate. Leggi l’ambito di ciascun report: nessuno dei due rappresenta tutte le risposte dell’IA o tutte le interazioni con i clienti.
Confronta queste osservazioni con le visite dai link di riferimento e le richieste di contatto nei tuoi dati analitici. Evita di trattare il numero di citazioni come un numero di clic o un cambiamento successivo al rilascio come prova di un rapporto di causa ed effetto.
Ad esempio, una richiesta riuscita mostra che una pagina è stata inviata. Una citazione mostra che un servizio l’ha menzionata in una risposta osservata. Una richiesta di contatto mostra un risultato per l’attività. Ognuna risponde a una domanda diversa.
Per valutare insieme questi livelli, la diagnostica GEO di Deep Analytics copre la visibilità nelle ricerche con IA e la sua misurazione. Parti dalla politica desiderata, poi verifica ciò che il sito restituisce davvero.
Ci sono dei limiti. Robots.txt comunica istruzioni ai crawler che scelgono di rispettarle; i contenuti privati richiedono autenticazione e controlli di accesso. Inoltre, un’esclusione attuale non dimostra che contenuti raccolti in precedenza siano stati rimossi da un modello già addestrato. Considerazioni sulla sicurezza del Robots Exclusion Protocol
8. TL;DR
- Puoi limitare l’addestramento e mantenere l’accesso per la ricerca? A volte. OpenAI e Anthropic separano le scelte dei crawler; Apple offre un token distinto per l’addestramento. Verifica ogni fornitore e gli usi raggruppati nei suoi controlli.
- Google? Esamina Google-Extended, l’impostazione di Search Console per l’inclusione nell’IA e i controlli delle anteprime a livello di pagina. Rimuovere una pagina con
noindexsacrifica la visibilità nella ricerca. - NOARCHIVE o NOCACHE? NOARCHIVE di Microsoft sacrifica anche la visibilità in Chat/Copilot. NOCACHE consente un riutilizzo limitato per l’addestramento. Configura i metadati della pagina o un header di risposta HTTP.
- Usi Cloudflare? Disallow AI Training combina preferenze e blocchi. Esamina le impostazioni Search, Training e Agent, comprese le scelte migrate.
- Che cosa dimostra il successo? Verifica i contenuti effettivamente inviati, poi misura separatamente la visibilità e i risultati per l’attività. Il solo permesso di accesso non garantisce né citazioni né ricavi.
Scegli gli usi che desideri, comprendi i compromessi e verifica ciò che il sito restituisce davvero.