Votre entreprise publie un guide utile. Vous voulez que les clients le trouvent sur Google, interrogent ChatGPT à son sujet et suivent un lien vers votre site. Mais vous ne souhaitez pas forcément que ce même guide serve à entraîner le prochain modèle d’IA.
Peut-on choisir l’un sans accepter l’autre ?
Parfois. La réponse dépend du fournisseur, du produit et du réglage utilisé. Certains acteurs séparent l’entraînement de la recherche. D’autres regroupent l’entraînement avec des usages qui contribuent aussi à faire découvrir votre contenu. Un réglage général de « blocage de l’IA » peut donc supprimer des possibilités que vous souhaitiez conserver.
Pour un propriétaire de site, c’est un aspect concret de l’optimisation pour les moteurs génératifs, ou GEO : comprendre comment votre contenu devient accessible aux services d’IA et déterminer quels usages servent votre activité.
Documentation des fournisseurs vérifiée le 1er octobre 2026. Consultez à nouveau les recommandations citées avant de modifier un site en production.
Dans ce guide
1. Une même page peut servir quatre usages différents
Avant de modifier un réglage, distinguez les usages que vous cherchez à contrôler.
L’entraînement contribue à développer ou à améliorer un modèle. La recherche permet à un service de découvrir et d’indexer des pages pour qu’elles puissent être trouvées ultérieurement. L’ancrage dans des sources (« grounding ») fournit des informations pendant la rédaction d’une réponse. La consultation à la demande d’un utilisateur intervient lorsqu’une personne demande à un assistant d’ouvrir une page précise.
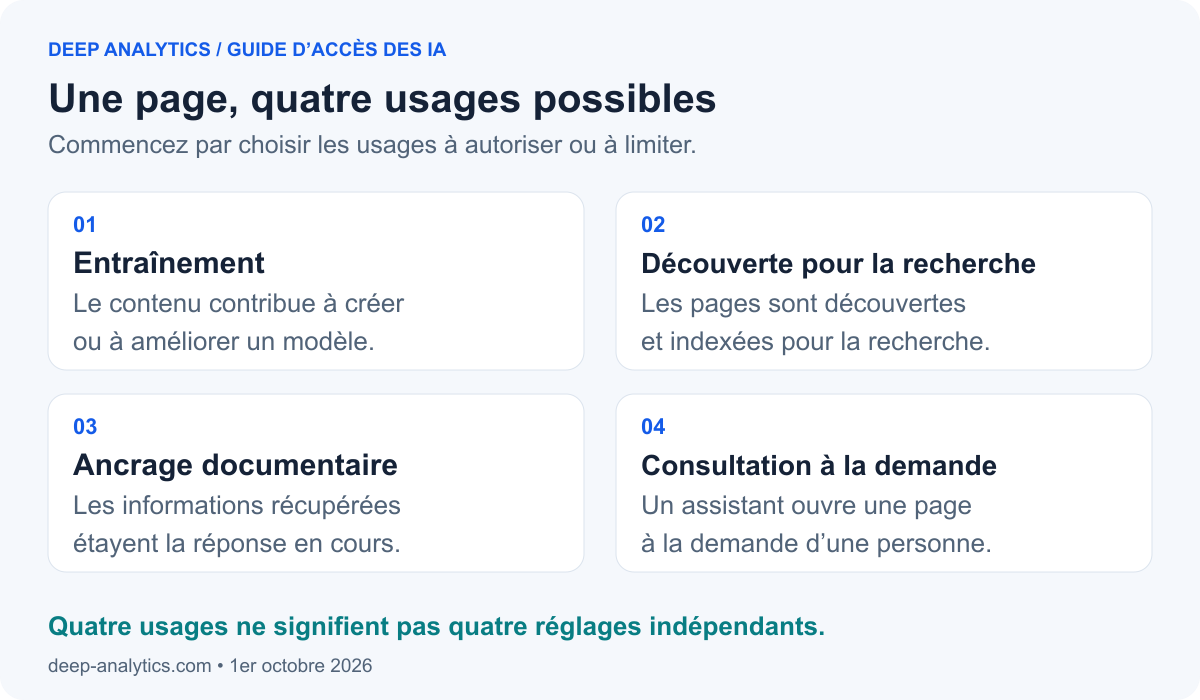
Il s’agit de quatre usages. Ils ne correspondent pas forcément à quatre robots distincts ou à quatre réglages indépendants.
Imaginez qu’un client demande à un assistant si votre cabinet de conseil intervient en Italie. L’assistant peut consulter votre page de services actuelle pour répondre. C’est un usage différent de la contribution de cette page au développement antérieur du modèle.
Cette distinction explique pourquoi « je veux bloquer l’IA » est une consigne incomplète. Une politique plus utile serait : « Maintenir l’accès à nos pages publiques pour la recherche et les demandes des clients ; restreindre les usages d’entraînement pour lesquels un réglage existe. » Reste à savoir quels fournisseurs permettent ce choix sans renoncer à autre chose.
Les modalités varient selon le fournisseur. La documentation d’Anthropic sur ses robots et les explications de Google sur l’ancrage dans des sources illustrent ces différences.
2. Où placer les réglages
Un robot d’exploration est un logiciel qui demande automatiquement des pages web. Votre site peut lui communiquer des consignes à plusieurs endroits, et votre service de sécurité peut décider de laisser passer ou non sa requête.
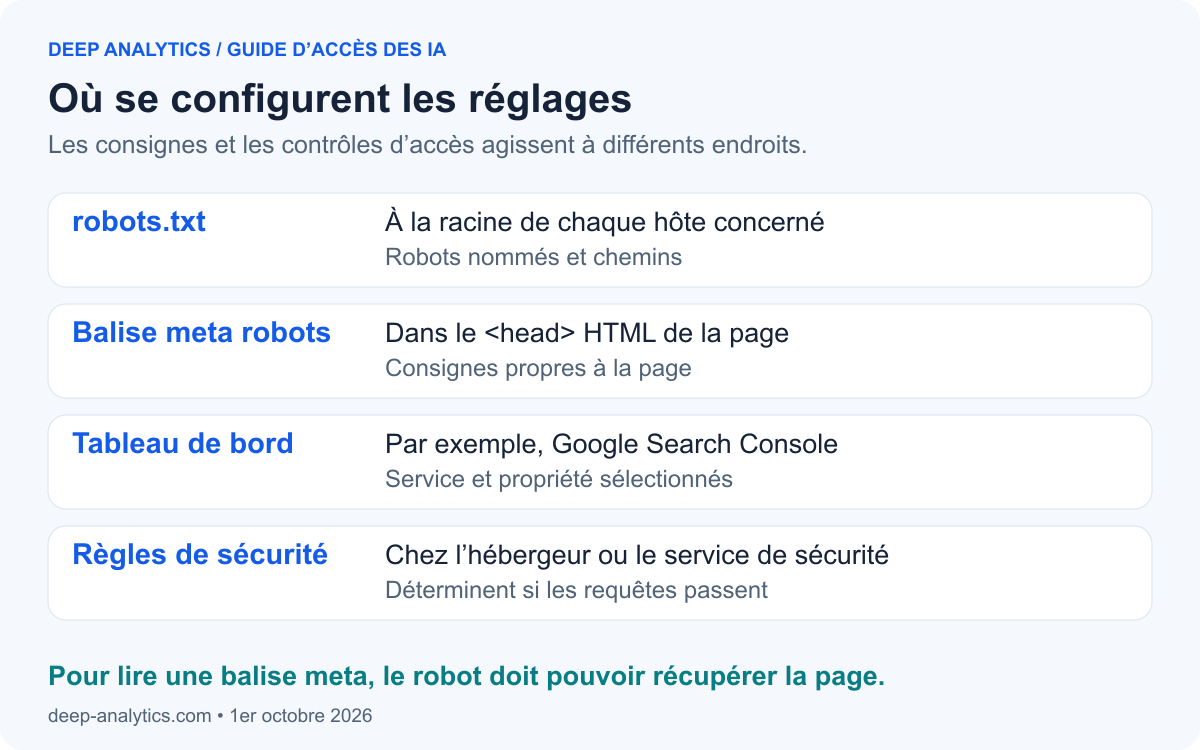
Robots.txt est un fichier texte situé à la racine d’un site, par exemple https://example.com/robots.txt. Ses règles visent des robots nommés et des chemins du site. Examinez chaque hôte concerné : une règle sur votre domaine principal n’exprime pas automatiquement la même politique pour tous les sous-domaines.
Une balise meta robots se place dans la section HTML <head> de la page, qui contient les métadonnées. Cette section est distincte de l’en-tête visible ou de la navigation. Coller une balise dans le texte de l’article ne la configure pas. Un modèle de page ou un réglage SEO de votre système de gestion de contenu peut générer cette balise.
Les réglages du tableau de bord s’appliquent au sein du service d’un fournisseur, comme Google Search Console. Les règles du pare-feu interviennent dans la couche de sécurité que traversent les requêtes. Ces contrôles doivent être cohérents avec la politique souhaitée.
À retenir : un robot doit récupérer la page pour lire une balise meta qu’elle contient. Bloquer cette requête peut l’empêcher de voir votre consigne.
Sources : emplacement et portée de robots.txt et métadonnées des pages et accès des robots.
3. Comparer les réglages des fournisseurs
Commencez par les services qu’utilisent vos clients. Le nom d’un robot indique quelle règle appliquer ; la documentation du fournisseur précise ce que cette règle change réellement.
OpenAI et Anthropic : des choix distincts pour l’entraînement et la recherche
OpenAI, l’entreprise à l’origine de ChatGPT, distingue GPTBot, qui collecte des contenus susceptibles de servir à l’entraînement, de OAI-SearchBot, destiné à la recherche. Leurs réglages robots.txt sont indépendants. Anthropic, l’entreprise à l’origine de Claude, sépare ClaudeBot de Claude-SearchBot de manière similaire.
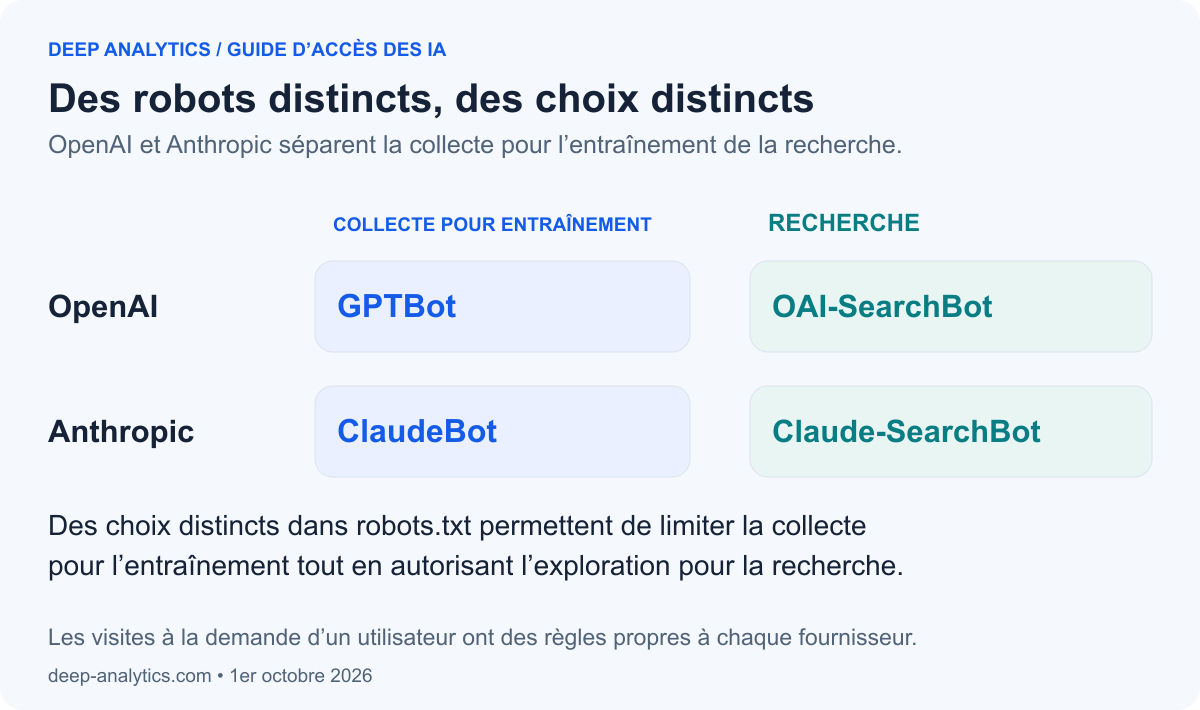
Pour les visites à la demande d’un utilisateur, les règles diffèrent. Anthropic indique que Claude-User respecte robots.txt. OpenAI précise que robots.txt peut ne pas s’appliquer à certaines requêtes effectuées via ChatGPT-User. Autoriser un robot de recherche rend l’accès possible ; cela ne garantit pas une citation.
Sources : la documentation d’OpenAI sur ses robots et la documentation d’Anthropic sur ses robots.
Autres fournisseurs à inclure dans votre audit
- Perplexity :
PerplexityBotsert à la recherche et ne collecte pas de contenus pour l’entraînement de modèles de fondation.Perplexity-Userrécupère des pages pour les utilisateurs et ignore généralement robots.txt. Vérifiez à la fois l’accès des robots et les réglages de votre pare-feu. Consultez les recommandations de Perplexity sur ses robots. - Apple :
Applebotsert à la recherche.Applebot-Extendedest un jeton de contrôle de l’entraînement dans robots.txt, et non un robot distinct ; l’interdire préserve l’éligibilité à la recherche. Le contrôlenosnippetd’Apple restreint aussi l’utilisation dans les réponses de l’IA : traitez-le comme une décision distincte concernant la visibilité. Consultez la documentation d’Apple. - Amazon :
Amzn-SearchBotsert à la recherche sans collecter de contenus pour l’entraînement ;Amzn-Userrécupère des informations pour les utilisateurs et peut ne pas suivre toutes les directives de robots.txt.Amazonbotcouvre des usages plus larges d’amélioration des produits, qui peuvent inclure l’entraînement. Amazon documente également la directivenoarchiveau niveau de la page pour restreindre l’entraînement. Consultez les recommandations d’Amazon sur ses robots. - Meta :
Meta-WebIndexersert à la recherche de Meta AI.Meta-ExternalAgentcouvre l’entraînement et l’indexation directe : le bloquer affecte donc ces deux usages documentés.Meta-ExternalFetchertraite les requêtes des utilisateurs et d’autres fonctions liées aux agents, et peut contourner robots.txt. Consultez la documentation de Meta sur ses robots. - Common Crawl :
CCBotcollecte un jeu de données web ouvert que d’autres peuvent réutiliser. Le restreindre agit sur la collecte dans ce jeu de données, et non sur un service réservé à l’entraînement ; ce n’est pas non plus un refus universel des usages ultérieurs. Consultez la présentation du jeu de données de Common Crawl et les recommandations pour identifier son robot.
Google et Microsoft nécessitent une attention particulière, car leurs réglages impliquent des compromis supplémentaires. Les deux sections suivantes leur sont consacrées.
Un exemple de robots.txt commenté à adapter
Cet extrait illustre des restrictions d’entraînement distinctes pour OpenAI, Anthropic et Apple, tout en autorisant certains robots de recherche nommés à accéder aux pages publiques. Adaptez-le à votre configuration existante. Il ne remplace pas le fichier robots.txt complet de votre site.
# Restrictions d’entraînement pour ces trois fournisseurs
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Applebot-Extended
Disallow: /

# Robots de recherche : les pages publiques restent explorables
# /admin/ est un EXEMPLE : conservez vos restrictions réelles.
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
User-agent: Amzn-SearchBot
User-agent: Meta-WebIndexer
User-agent: Googlebot
User-agent: Bingbot
User-agent: Applebot
Disallow: /admin/

# Groupe par défaut pour les robots sans groupe plus spécifique
# Conservez toutes les règles applicables du fichier existant.
User-agent: *
Disallow: /admin/
User-agent identifie le robot ou le jeton de contrôle. Plusieurs noms peuvent partager un même groupe. Disallow: / s’applique à tous les chemins ; /admin/ ne s’applique qu’à ce répertoire d’exemple. Les autres chemins restent autorisés selon les règles présentées.
Les groupes nommés n’héritent pas des restrictions du groupe générique. Fusionnez soigneusement les règles existantes et répétez les restrictions de chemins pertinentes dans chaque groupe nommé. Les robots qui consultent des pages à la demande des utilisateurs relèvent ici du groupe par défaut ; les exceptions de leurs fournisseurs continuent de s’appliquer. Le protocole d’exclusion des robots explique la sélection des groupes.
L’exemple laisse volontairement Google-Extended, Amazonbot, Meta-ExternalAgent et CCBot faire l’objet de décisions distinctes. Il n’exprime pas non plus la restriction d’entraînement de Microsoft. Lisez les implications de ces réglages avant d’ajouter des règles. Les contenus privés nécessitent toujours une authentification : robots.txt est public et ne constitue pas une barrière de sécurité.
4. Google nécessite trois vérifications
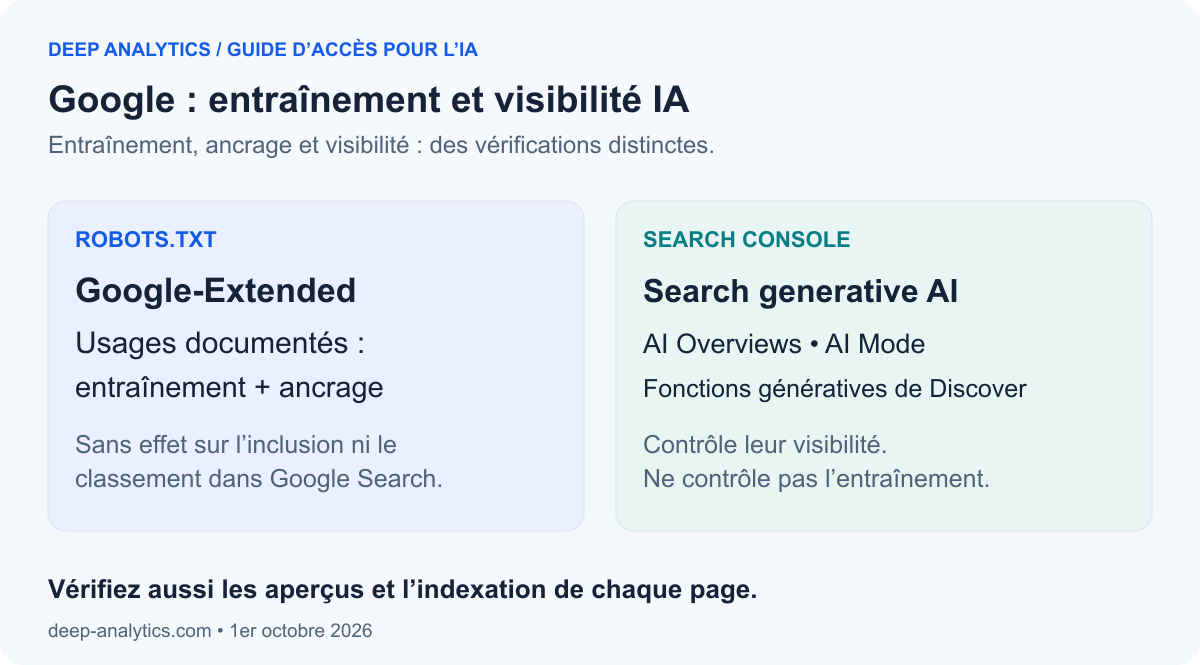
Les réglages de Google agissent à différents niveaux : usages autorisés pour les modèles, inclusion dans les fonctionnalités de recherche IA et contenu que chaque page peut afficher. Vérifiez les trois avant de conclure qu’un site est correctement configuré.
Vérification 1 : Google-Extended couvre l’entraînement et certains usages d’ancrage
Google-Extended est un jeton de contrôle dans robots.txt, et non le nom d’un robot HTTP distinct à rechercher dans les journaux du serveur. Son périmètre documenté inclut l’entraînement de Gemini et l’ancrage dans des sources dans Gemini Apps et Vertex AI, la plateforme de Google pour créer des applications d’IA. Le bloquer restreint aussi ces usages d’ancrage ; cela n’affecte ni l’inclusion ni le classement dans Google Search.
Le présenter comme un simple interrupteur d’entraînement masquerait ce compromis. Consultez la documentation de Google sur ses robots.
Vérification 2 : Search Console contrôle l’inclusion dans la recherche IA
Search Console est l’outil de Google pour les propriétaires de sites. Dans Settings → Search generative AI, ils peuvent gérer l’inclusion dans AI Overviews, AI Mode et les fonctionnalités génératives de Discover. Google indique que ce réglage est disponible dans le monde entier depuis le 31 août 2026.
Exclure une propriété supprime ses contenus et ses liens de ces fonctionnalités sans modifier son inclusion ni son classement dans les autres parties de Search. Vérifiez si elle hérite du choix d’une propriété parente. Ce réglage ne contrôle pas l’entraînement : la page d’aide de Google renvoie vers Google-Extended pour restreindre l’entraînement des modèles utilisés dans ces fonctionnalités. Consultez les recommandations de Search Console.
Vérification 3 : aperçus et indexation au niveau de la page
L’accès de Googlebot à l’exploration et les consignes de page restent déterminants. Les contrôles ci-dessous ont des effets différents :
data-nosnippetexclut certains passages des extraits ; appliquez-le à un élément<span>,<div>ou<section>entourant le texte concerné.max-snippetlimite le texte disponible pour les aperçus. Ce n’est ni un refus général de l’entraînement ni une garantie qu’une fonctionnalité IA disparaîtra.nosnippetempêche les extraits textuels et restreint l’utilisation directe comme donnée d’entrée pour AI Overviews et AI Mode.noindexretire la page de Google Search une fois la directive traitée. Cela sacrifie sa visibilité dans la recherche et ne doit pas servir uniquement à restreindre l’entraînement.
Les balises meta robots qui s’appliquent à toute la page se placent dans le <head> HTML. Bloquer Googlebot dans robots.txt peut l’empêcher de les voir. Ces choix peuvent aussi affecter la présentation dans les résultats de recherche classiques. Sources : les recommandations de Google sur les fonctionnalités IA et les spécifications des métadonnées robots.
5. Les balises Microsoft impliquent un compromis sur la visibilité
Bing est le moteur de recherche de Microsoft et son index contribue au fonctionnement de Copilot. L’explication initiale de Microsoft date de l’époque de Bing Chat, en 2023 ; sa page d’aide Bing actuelle décrit les contrôles pour Chat et Copilot.
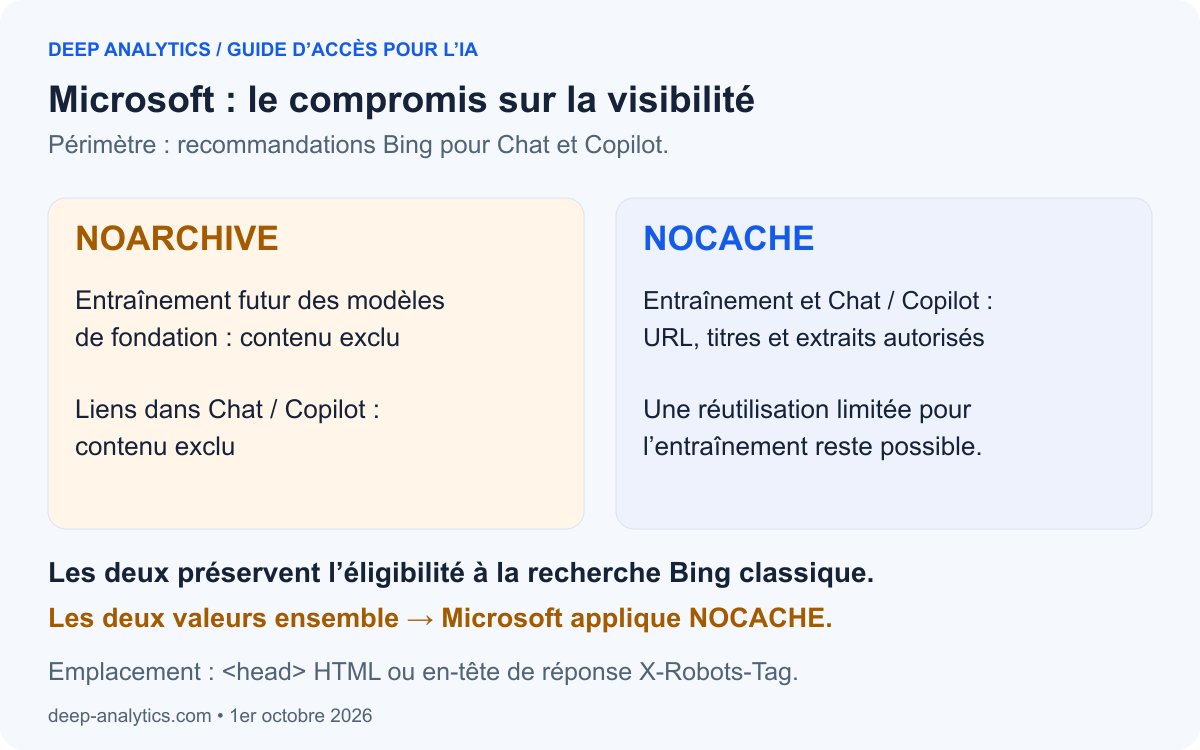
Pour demander l’application de NOARCHIVE à Bing, placez cette balise dans la section <head> du code HTML de la page concernée :
<meta name="bingbot" content="noarchive">Cela restreint l’entraînement des modèles de fondation et sacrifie les liens dans Chat/Copilot. L’annonce de 2023 explique aussi l’exclusion des réponses, tout en maintenant l’éligibilité à la recherche Bing classique.
L’autre option est :
<meta name="bingbot" content="nocache">NOCACHE autorise les URL, les titres et les extraits dans Chat/Copilot et pour l’entraînement. Ce n’est pas un refus complet de l’entraînement. Si les deux valeurs sont présentes, Microsoft applique NOCACHE.
Pour les PDF et autres fichiers : utiliser un en-tête de réponse
Un PDF n’a pas de section HTML <head>. Configurez le serveur web ou le CDN pour envoyer un en-tête de réponse HTTP avec le fichier, par exemple :
X-Robots-Tag: bingbot: noarchiveIl s’agit de métadonnées de réponse, et non d’une ligne à coller dans le PDF ou dans robots.txt. Bing prend en charge ses directives robots via X-Robots-Tag ; vérifiez l’en-tête effectivement envoyé après configuration. Les recommandations de Microsoft sur les en-têtes des contenus non HTML expliquent où les placer.
Pour le HTML, name="robots" applique la consigne plus largement ; name="bingbot" la limite à Bing. Vérifiez l’interprétation des autres fournisseurs avant d’élargir sa portée. Utilisez le CMS ou le modèle qui génère les pages concernées, et choisissez délibérément une politique. NOCACHE désigne ici autre chose que l’en-tête HTTP Cache-Control utilisé pour la mise en cache par les navigateurs et les CDN.
6. Cloudflare peut arrêter un robot avant qu’il atteigne votre page
Cloudflare fournit des services de performance et de sécurité pour les sites web. Pour le trafic qui transite par son réseau, il se place entre le visiteur ou le robot et le serveur qui héberge votre site. Il peut servir du contenu en cache et filtrer les requêtes avant qu’elles atteignent ce serveur. Comment fonctionne Cloudflare
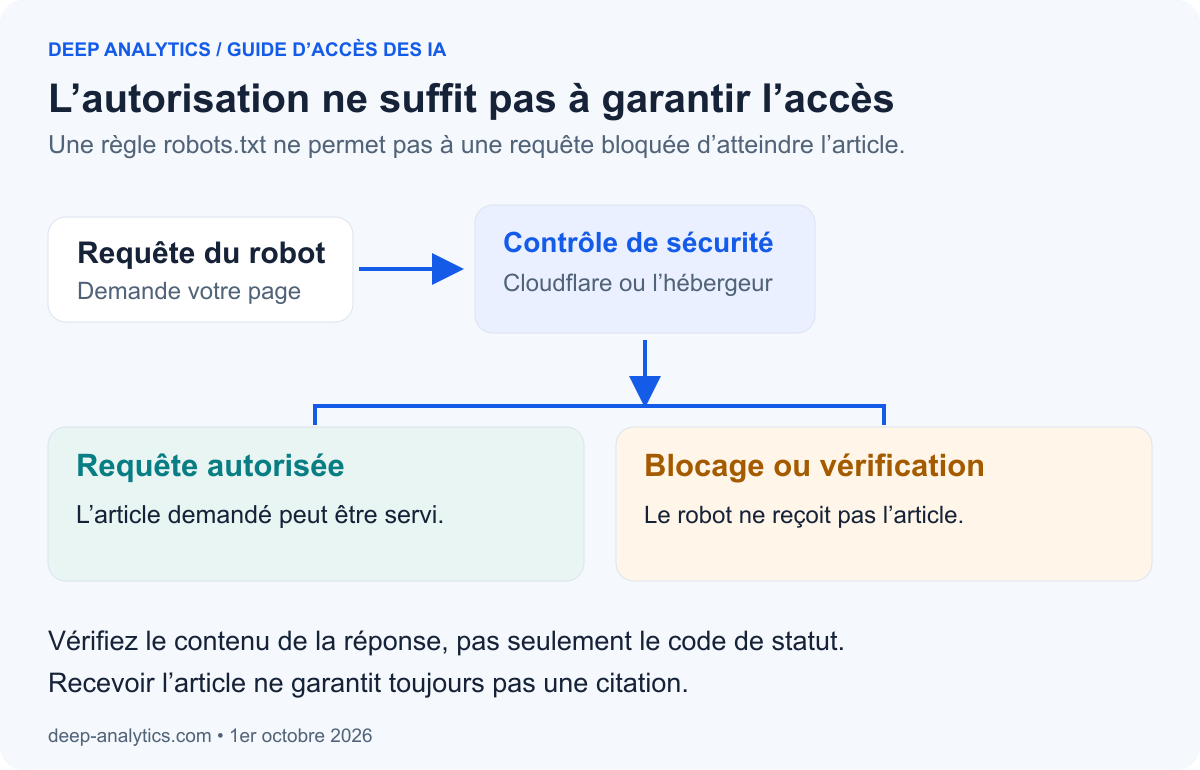
Il fait donc partie de votre configuration de visibilité dans la recherche. Une règle robots.txt permissive est de peu d’utilité si un pare-feu renvoie un blocage ou un écran de vérification à la place de votre article.
Les changements de Cloudflare de septembre 2026 distinguent trois contrôles :
- Search : exploration pour constituer un index de recherche.
- Training : collecte de contenus pour développer les modèles.
- Agent : visites pour le compte d’un utilisateur.
Avec Disallow AI Training, Bot Preference Sync publie les préférences d’entraînement prises en charge dans robots.txt. Les robots à usages multiples qui remplissent les conditions restent autorisés pour la recherche ; les autres robots d’entraînement sont activement bloqués. Un robot à usages multiples remplit plusieurs fonctions.
Block peut aussi arrêter Googlebot, Bingbot et Applebot, ce qui affecte leur accès pour la recherche. Cloudflare remplace ses anciens contrôles, et les blocages Training précédents migrent vers Disallow AI Training. Vérifiez aussi le réglage Agent obtenu : certaines configurations migrées et le préréglage pour les sites financés par la publicité bloquent les agents sur les pages contenant des annonces.
La préférence d’entraînement de Microsoft au niveau du site, via robots.txt, reste prévue pour début 2027. Tant qu’elle n’est pas disponible, Disallow AI Training ne transmet pas automatiquement cette préférence à Bing via robots.txt ; examinez séparément les contrôles Microsoft au niveau des pages ou des en-têtes.
Source : les réglages Cloudflare, les tableaux de migration et les limites propres aux fournisseurs.
À retenir en pratique : examinez à la fois le robots.txt effectivement servi et les règles de sécurité. Un statut HTTP de réussite ne suffit pas : une page de vérification n’est pas l’article que le robot souhaitait consulter.
7. Comment vérifier les effets réels de vos réglages
Commencez par une décision métier : quels usages aident les clients à trouver et à évaluer votre entreprise, et lesquels souhaitez-vous restreindre ? Procédez ensuite à ces cinq vérifications.
- Consignez la politique souhaitée. Pour chaque fournisseur, documentez l’entraînement, la recherche, l’ancrage dans des sources et l’accès à la demande des utilisateurs. Notez les cas où les réglages disponibles regroupent plusieurs usages.
- Repérez tous les réglages pertinents. Examinez robots.txt, les modèles de pages, les tableaux de bord des fournisseurs et les règles de sécurité. Incluez les sous-domaines importants et les différentes versions linguistiques.
- Inspectez ce que le site sert réellement. Vérifiez le fichier robots.txt public et le HTML des pages. Un réglage dans un éditeur témoigne de votre intention ; la réponse délivrée montre ce qu’un robot peut recevoir.
- Vérifiez l’accès des vrais robots. Comparez les journaux du serveur ou de sécurité aux plages IP officielles ou aux vérifications DNS documentées par le fournisseur. Copier un nom de user-agent n’est qu’un test de diagnostic : n’importe quel client peut revendiquer ce nom.
- Mesurez les résultats séparément. Suivez les échecs d’exploration, l’indexation, les citations IA sur un échantillon, les visites référentes et les demandes de contact. Consignez les dates de modification des réglages pour examiner les résultats sans supposer qu’une concordance temporelle prouve un lien de causalité.
Rendre la vérification d’accès concrète
Pour Perplexity, une exception au pare-feu doit correspondre à la fois au user-agent attendu et à une IP appartenant aux plages officiellement publiées. Tenez ces plages à jour et limitez l’exception à l’accès prévu pour le robot. Les recommandations de Perplexity sur les pare-feu expliquent cette approche. OpenAI, Amazon, Apple et Common Crawl documentent également des méthodes de vérification dans les pages citées plus haut.
Utiliser les rapports en complément de vos données d’analyse
Google propose un rapport de performances de l’IA générative. Bing Webmaster Tools propose un rapport AI Performance qui couvre les citations dans les expériences Microsoft et partenaires prises en charge. Lisez le périmètre de chaque rapport : aucun ne représente toutes les réponses IA ni toutes les interactions avec les clients.
Comparez ces observations aux visites référentes et aux demandes de contact dans vos propres données d’analyse. Évitez d’assimiler un nombre de citations à un nombre de clics, ou un changement après déploiement à une preuve de causalité.
Par exemple, une requête réussie montre qu’une page a été délivrée. Une citation montre qu’un service l’a référencée dans une réponse observée. Une demande de contact montre une réaction commerciale. Chacun de ces indicateurs répond à une question différente.
Pour évaluer ces niveaux ensemble, le diagnostic GEO de Deep Analytics couvre la visibilité dans la recherche IA et sa mesure. Partez de la politique souhaitée, puis vérifiez ce que le site délivre réellement.
Il existe des limites. Robots.txt communique des consignes aux robots qui les respectent ; les contenus privés nécessitent une authentification et des contrôles d’accès. Un refus actuel ne prouve pas non plus que les contenus déjà collectés ont été retirés d’un modèle déjà entraîné. Considérations de sécurité du protocole d’exclusion des robots
8. En bref
- Peut-on restreindre l’entraînement et conserver l’accès pour la recherche ? Parfois. OpenAI et Anthropic proposent des choix distincts selon les robots ; Apple offre un jeton séparé pour l’entraînement. Vérifiez chaque fournisseur et les usages regroupés dans ses contrôles.
- Google ? Examinez Google-Extended, le réglage d’inclusion dans l’IA de Search Console et les contrôles d’aperçu au niveau des pages. Retirer une page avec
noindexsacrifie sa visibilité dans la recherche. - NOARCHIVE ou NOCACHE ? Chez Microsoft, NOARCHIVE sacrifie aussi la visibilité dans Chat/Copilot. NOCACHE autorise une réutilisation limitée pour l’entraînement. Configurez les métadonnées de page ou un en-tête de réponse HTTP.
- Vous utilisez Cloudflare ? Disallow AI Training combine préférences et blocage. Examinez les réglages Search, Training et Agent, y compris les choix issus d’une migration.
- Qu’est-ce qui prouve la réussite ? Vérifiez le contenu délivré, puis mesurez séparément la visibilité et les résultats commerciaux. Une autorisation seule ne garantit ni citations ni chiffre d’affaires.
Choisissez les usages souhaités, comprenez les compromis et vérifiez ce que votre site délivre réellement.