Tu empresa publica una guía útil. Quieres que los clientes la encuentren en Google, pregunten a ChatGPT sobre ella y sigan un enlace a tu web. Pero quizá no quieras que esa misma guía se utilice para entrenar el próximo modelo de IA.
¿Puedes elegir una cosa sin aceptar la otra?
A veces. La respuesta depende del proveedor, del producto y del control que utilices. Algunas empresas separan el entrenamiento de las búsquedas. Otras agrupan el entrenamiento con usos que también ayudan a descubrir tu contenido. Por tanto, un ajuste genérico para «bloquear la IA» puede eliminar oportunidades que querías conservar.
Para quien gestiona una web, esta es una parte práctica de la optimización para motores generativos, o GEO: entender cómo llega tu contenido a los servicios de IA y decidir qué usos favorecen a tu negocio.
Documentación de los proveedores revisada el 1 de octubre de 2026. Vuelve a consultar las guías enlazadas antes de modificar un sitio en producción.
En esta guía
1. Una página puede tener cuatro usos distintos
Antes de cambiar un ajuste, distingue los usos que quieres controlar.
El entrenamiento ayuda a desarrollar o mejorar un modelo. La búsqueda ayuda a un servicio a descubrir e indexar páginas para poder encontrarlas más adelante. El grounding aporta información mientras se redacta una respuesta. La recuperación a petición del usuario se produce cuando alguien pide a un asistente que abra una página concreta.
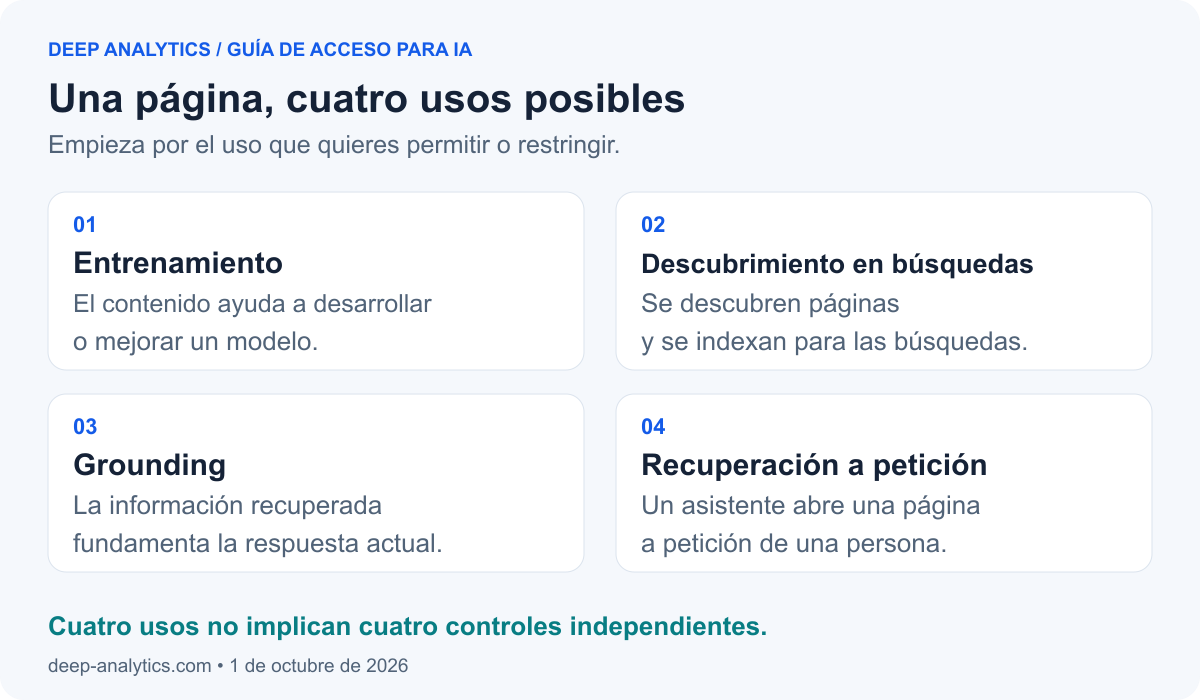
Son cuatro finalidades. No corresponden necesariamente a cuatro rastreadores distintos ni a cuatro ajustes independientes.
Imagina que un cliente pregunta a un asistente si tu consultora trabaja en Italia. El asistente podría consultar tu página actual de servicios para responder. Eso es distinto de que tu página haya contribuido al desarrollo previo del modelo.
Esta distinción explica por qué «quiero bloquear la IA» es una instrucción incompleta. Una política más útil sería: «Mantener nuestras páginas públicas disponibles para las búsquedas y las consultas de clientes; restringir los usos de entrenamiento que los controles permitan limitar». La cuestión que queda por resolver es qué proveedores te permiten tomar esa decisión sin renunciar a algo más.
Las opciones varían según el proveedor. La documentación de Anthropic sobre sus rastreadores y la explicación de Google sobre el grounding ilustran esas diferencias.
2. Dónde se configura cada control
Un rastreador es un programa que solicita páginas web de forma automática. Tu web puede comunicarle instrucciones en distintos lugares, y tu servicio de seguridad puede decidir si permite que la solicitud pase.
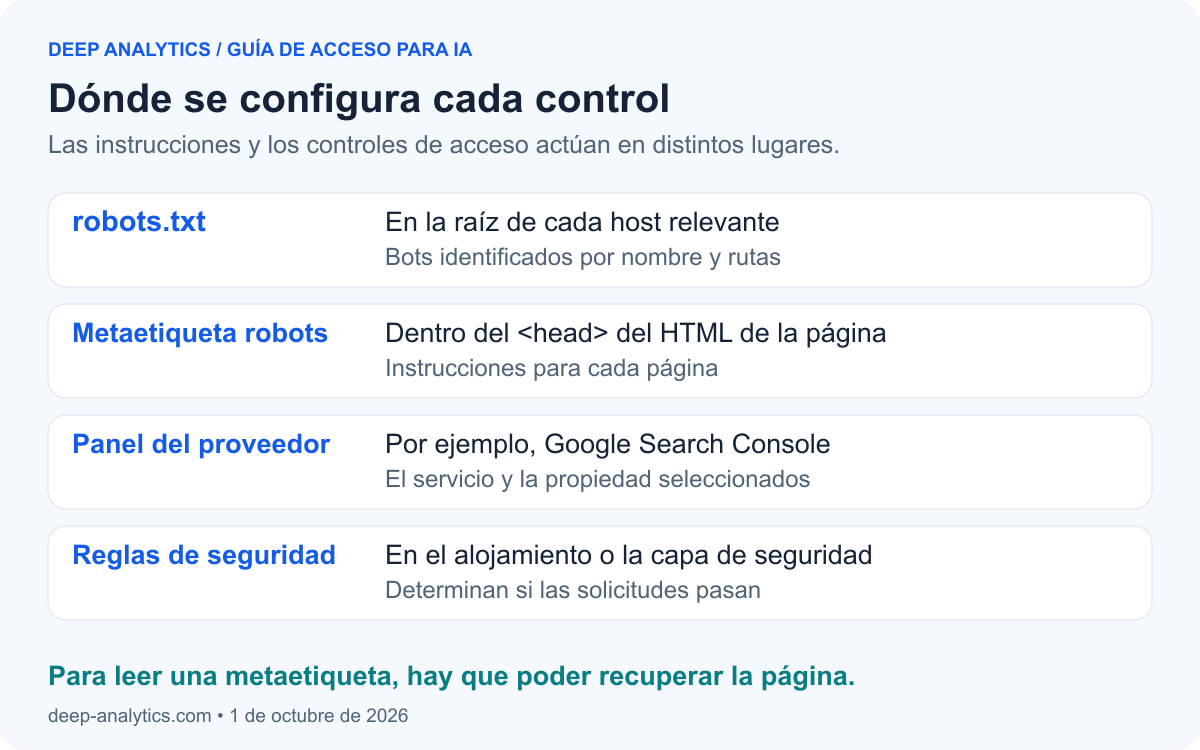
Robots.txt es un archivo de texto situado en la raíz de una web, como https://example.com/robots.txt. Sus reglas se dirigen a bots identificados por su nombre y a rutas de la web. Revisa cada host relevante: una regla en tu dominio principal no establece automáticamente la misma política para todos los subdominios.
Una metaetiqueta robots se coloca dentro del <head> del HTML de la página, donde se almacenan los metadatos. Es distinto de la cabecera visible o del menú de navegación. Pegar una etiqueta en el texto del artículo no la configura. La etiqueta puede generarse desde una plantilla de la web o un ajuste SEO de tu gestor de contenidos.
Los ajustes del panel se aplican dentro del servicio de un proveedor, como Google Search Console. Las reglas del cortafuegos actúan en la capa de seguridad por la que pasan las solicitudes. Estos controles deben ser coherentes con la política que quieres aplicar.
Recuerda: un rastreador tiene que recuperar la página para leer una metaetiqueta incluida en ella. Si bloqueas esa solicitud, puedes impedir que vea tu instrucción.
Fuentes: ubicación y alcance de robots.txt y metadatos de página y acceso de los rastreadores.
3. Compara los controles de los proveedores
Empieza por los servicios que utilizan tus clientes. El nombre de un rastreador indica qué regla aplicar; la documentación del proveedor explica qué cambia realmente esa regla.
OpenAI y Anthropic: decisiones independientes para entrenamiento y búsqueda
OpenAI, la empresa detrás de ChatGPT, distingue entre GPTBot, que recopila contenido que podría utilizarse para entrenamiento, y OAI-SearchBot, destinado a la búsqueda. Sus ajustes en robots.txt son independientes. Anthropic, la empresa detrás de Claude, separa ClaudeBot de Claude-SearchBot de forma similar.
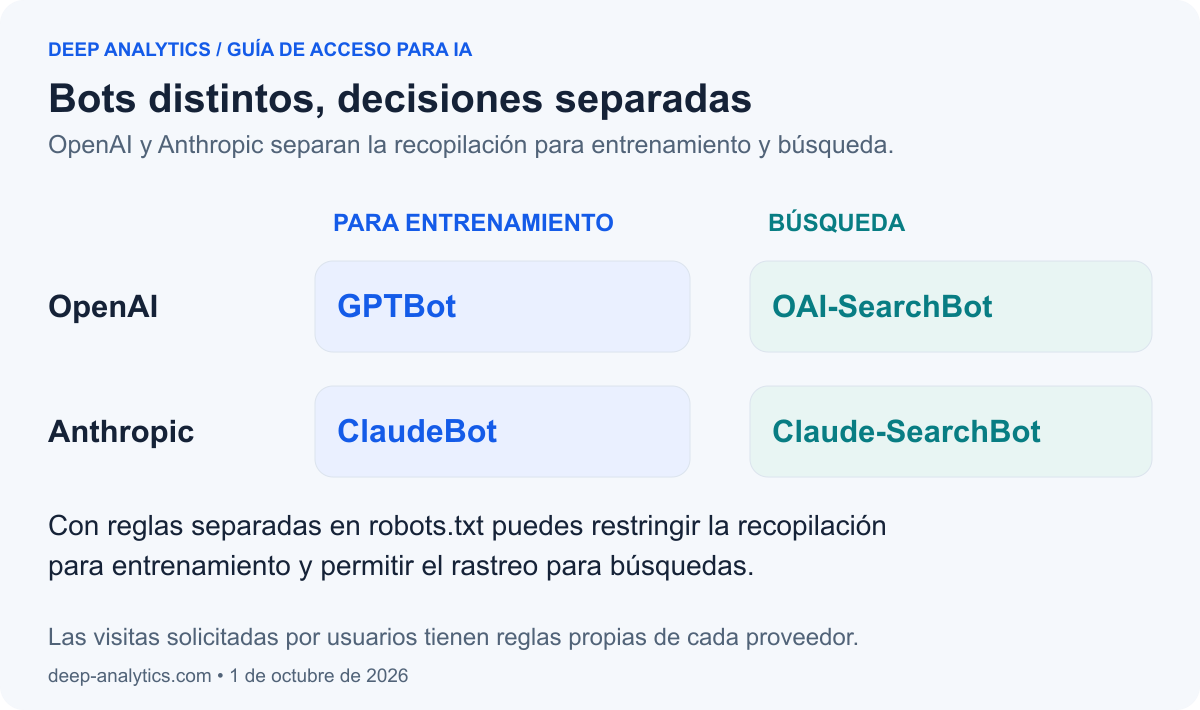
Las reglas cambian para las visitas solicitadas por usuarios. Anthropic indica que Claude-User respeta robots.txt. OpenAI señala que robots.txt puede no aplicarse a determinadas solicitudes realizadas mediante ChatGPT-User. Permitir un rastreador de búsqueda hace posible el acceso; no garantiza una cita.
Fuentes: documentación de rastreadores de OpenAI y documentación de rastreadores de Anthropic.
Otros proveedores que debes incluir en tu auditoría
- Perplexity:
PerplexityBotfacilita la búsqueda y no se utiliza para recopilar contenido destinado al entrenamiento de modelos fundacionales.Perplexity-Userrecupera páginas para los usuarios y generalmente ignora robots.txt. Revisa tanto el acceso de los rastreadores como los ajustes del cortafuegos. Consulta la guía de rastreadores de Perplexity. - Apple:
Applebotfacilita la búsqueda.Applebot-Extendedes un control de entrenamiento en robots.txt, no un rastreador independiente; bloquearlo mantiene la posibilidad de aparecer en búsquedas. El controlnosnippetde Apple también restringe el uso en respuestas de IA, por lo que debe tratarse como una decisión de visibilidad independiente. Consulta la documentación de Apple. - Amazon:
Amzn-SearchBotfacilita la búsqueda sin recopilar contenido para entrenamiento;Amzn-Userrecupera información para los usuarios y puede no seguir todas las directivas de robots.txt.Amazonbottiene usos más amplios de mejora de productos que pueden incluir el entrenamiento. Amazon también documentanoarchivea nivel de página como restricción del entrenamiento. Consulta la guía de rastreadores de Amazon. - Meta:
Meta-WebIndexerfacilita la búsqueda de Meta AI.Meta-ExternalAgentabarca el entrenamiento y la indexación directa, por lo que bloquearlo afecta a ambos usos documentados.Meta-ExternalFetcheratiende solicitudes de usuarios y otras funciones relacionadas con agentes, y puede omitir robots.txt. Consulta la documentación de rastreadores de Meta. - Common Crawl:
CCBotrecopila un conjunto abierto de datos de la web que otros pueden reutilizar. Restringirlo afecta a la recopilación para ese conjunto de datos; no se trata de un servicio exclusivo de entrenamiento ni de una exclusión universal de los usos posteriores. Revisa la descripción del conjunto de datos de Common Crawl y la guía de identificación del rastreador.
Google y Microsoft requieren más atención porque sus controles implican otras contrapartidas. Se explican en las dos secciones siguientes.
Un ejemplo comentado de robots.txt para adaptar
Este fragmento ilustra restricciones de entrenamiento independientes para OpenAI, Anthropic y Apple, al tiempo que permite a los rastreadores de búsqueda indicados acceder a las páginas públicas. Adáptalo a tu configuración actual. No sustituye al archivo robots.txt completo de tu sitio.
# Restricciones de entrenamiento para estos tres proveedores
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Applebot-Extended
Disallow: /

# Rastreadores de búsqueda: las páginas públicas siguen accesibles al rastreo
# /admin/ es una ruta de EJEMPLO: conserva tus restricciones reales.
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
User-agent: Amzn-SearchBot
User-agent: Meta-WebIndexer
User-agent: Googlebot
User-agent: Bingbot
User-agent: Applebot
Disallow: /admin/

# Grupo predeterminado para bots sin un grupo más específico
# Conserva todas las reglas aplicables de tu archivo actual.
User-agent: *
Disallow: /admin/
User-agent identifica el rastreador o el identificador de control. Varios nombres pueden compartir un mismo grupo. Disallow: / se aplica a todas las rutas; /admin/ se aplica únicamente a ese directorio de ejemplo. Las demás rutas siguen permitidas según las reglas mostradas.
Los grupos específicos no heredan las restricciones del grupo comodín. Integra con cuidado las reglas existentes y repite las restricciones de rutas pertinentes en cada grupo específico. En este ejemplo, los sistemas de recuperación a petición del usuario quedan dentro del grupo predeterminado; las excepciones de sus proveedores siguen siendo aplicables. El Protocolo de Exclusión de Robots explica cómo se determina el grupo aplicable.
El ejemplo deja deliberadamente Google-Extended, Amazonbot, Meta-ExternalAgent y CCBot como decisiones de política independientes. Tampoco expresa la restricción de entrenamiento de Microsoft. Lee sus implicaciones antes de añadir reglas. El contenido privado sigue requiriendo autenticación; robots.txt es público y no constituye una barrera de seguridad.
4. Google requiere tres comprobaciones
Los controles de Google actúan en distintos niveles: los usos permitidos para los modelos, la inclusión en funciones de búsqueda con IA y lo que puede mostrar cada página. Revisa los tres antes de concluir que un sitio está bien configurado.
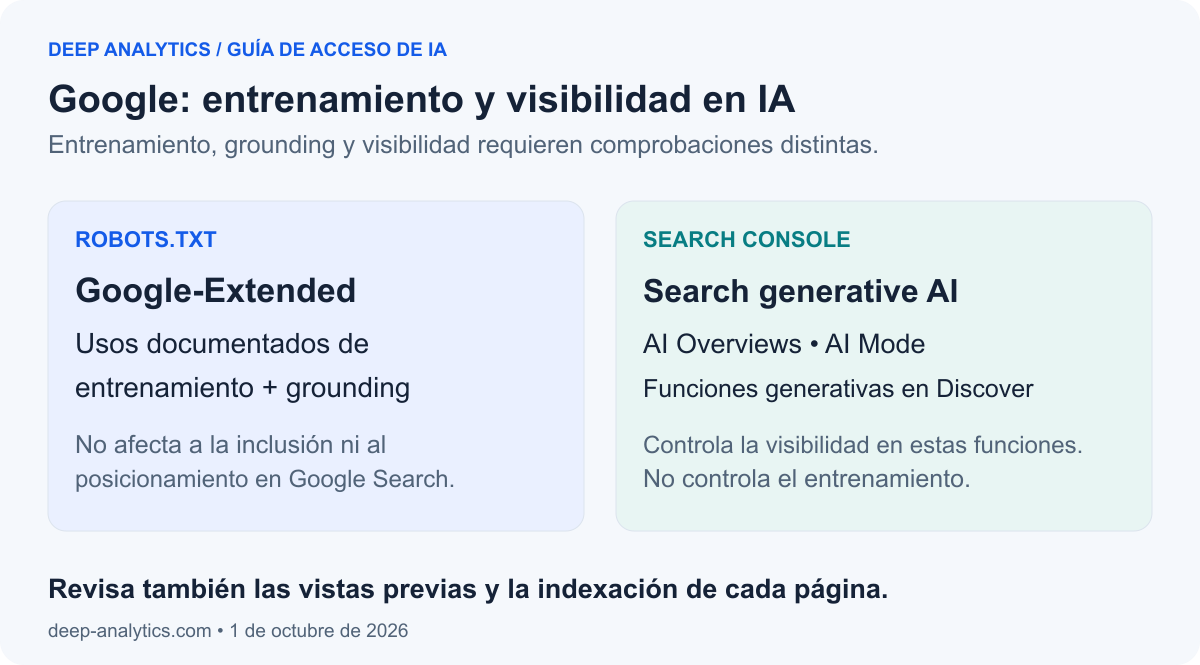
Comprobación 1: Google-Extended abarca el entrenamiento y algunos usos de grounding
Google-Extended es un identificador de control en robots.txt, no el nombre de un rastreador HTTP independiente que puedas buscar en los registros del servidor. Su alcance documentado incluye el entrenamiento de Gemini y el grounding en Gemini Apps y Vertex AI, la plataforma de Google para crear aplicaciones de IA. Bloquearlo también restringe esos usos de grounding; no afecta a la inclusión ni al posicionamiento en Google Search.
Llamarlo un interruptor exclusivo para entrenamiento ocultaría esa contrapartida. Consulta la documentación de rastreadores de Google.
Comprobación 2: Search Console controla la inclusión en búsquedas con IA
Search Console es la herramienta de Google para propietarios de sitios web. En Settings → Search generative AI, los propietarios pueden gestionar la inclusión en AI Overviews, AI Mode y las funciones generativas de Discover. Google indica que este control está disponible en todo el mundo desde el 31 de agosto de 2026.
Excluir una propiedad elimina su contenido y sus enlaces de esas funciones sin modificar la inclusión ni el posicionamiento en otras partes de Search. Comprueba si hereda la elección de una propiedad superior. Este ajuste no controla el entrenamiento: la página de ayuda de Google remite a Google-Extended para restringir el entrenamiento de los modelos utilizados en estas funciones. Consulta la guía de Search Console.
Comprobación 3: vistas previas e indexación de cada página
El acceso de rastreo de Googlebot y las instrucciones de página siguen siendo importantes. Los controles siguientes tienen efectos distintos:
data-nosnippetexcluye determinados pasajes de los fragmentos de resultados; aplícalo a un<span>,<div>o<section>que envuelva el texto correspondiente.max-snippetlimita el texto disponible para las vistas previas. No es una exclusión general del entrenamiento ni garantiza que desaparezca una función de IA.nosnippetimpide los fragmentos de texto y restringe el uso directo como entrada para AI Overviews y AI Mode.noindexelimina la página de Google Search una vez procesado. Sacrifica la visibilidad en búsquedas y no debe utilizarse solo para restringir el entrenamiento.
Las etiquetas meta robots que afectan a toda la página deben ir en el <head> del HTML. Bloquear Googlebot en robots.txt puede impedir que las vea. Estas decisiones también pueden afectar a la presentación en las búsquedas habituales. Fuentes: guía de Google sobre funciones de IA y especificaciones de metadatos robots.
5. Las etiquetas de Microsoft implican renunciar a cierta visibilidad
Bing es el buscador de Microsoft, y su índice contribuye al funcionamiento de las experiencias de Copilot. La explicación original de Microsoft data de la época de Bing Chat, en 2023; su página de ayuda actual de Bing describe los controles para Chat y Copilot.
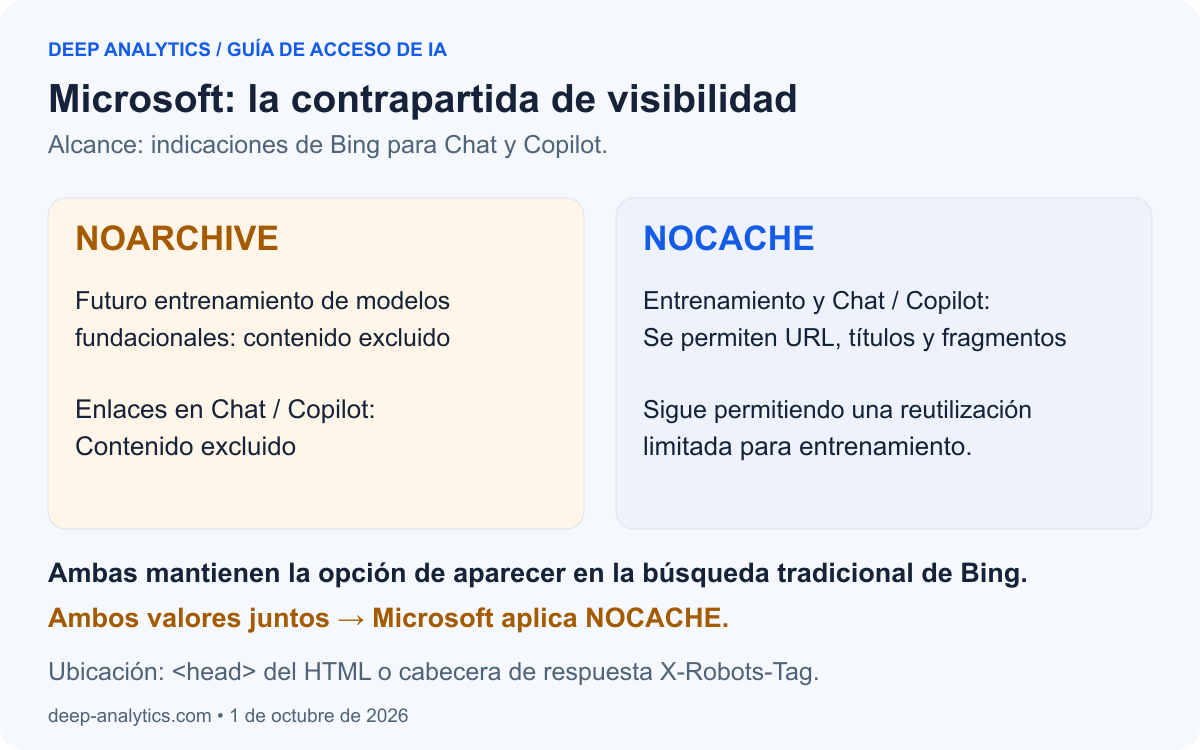
Para solicitar la política NOARCHIVE para Bing, coloca esta etiqueta dentro del <head> del HTML de la página afectada:
<meta name="bingbot" content="noarchive">Esto restringe el entrenamiento de modelos fundacionales e implica renunciar a los enlaces en Chat/Copilot. El anuncio de 2023 también explica la exclusión de las respuestas mientras se mantiene la posibilidad de aparecer en la búsqueda tradicional de Bing.
La alternativa es:
<meta name="bingbot" content="nocache">NOCACHE permite URL, títulos y fragmentos en Chat/Copilot y para entrenamiento. No es una exclusión completa del entrenamiento. Si están presentes ambos valores, Microsoft aplica NOCACHE.
Para PDF y otros archivos: utiliza una cabecera de respuesta
Un PDF no tiene un <head> de HTML. Configura el servidor web o la CDN para que envíe una cabecera de respuesta HTTP junto con el archivo, por ejemplo:
X-Robots-Tag: bingbot: noarchiveSe trata de metadatos de respuesta, no de una línea que debas pegar en el PDF o en robots.txt. Bing admite sus directivas robots mediante X-Robots-Tag; inspecciona la cabecera que se entrega después de configurarla. La guía de Microsoft sobre cabeceras para contenido no HTML explica dónde deben configurarse.
Para HTML, name="robots" aplica la instrucción de forma más amplia; name="bingbot" la limita a Bing. Revisa las interpretaciones de otros proveedores antes de ampliar su alcance. Utiliza el CMS o la plantilla que genera las páginas afectadas y elige una política de forma deliberada. Aquí NOCACHE es distinto de la cabecera HTTP Cache-Control, que se utiliza para la caché del navegador y de la CDN.
6. Cloudflare puede detener un rastreador antes de que llegue a tu página
Cloudflare ofrece servicios de rendimiento y seguridad web. En el tráfico que pasa por su red mediante proxy, actúa como intermediario entre el visitante o rastreador y el servidor que aloja tu web. Puede servir contenido en caché y filtrar solicitudes antes de que lleguen a ese servidor. Cómo funciona Cloudflare
Por eso forma parte de la configuración que determina tu visibilidad en las búsquedas. Una regla permisiva en robots.txt sirve de poco si un cortafuegos devuelve un bloqueo o una pantalla de verificación en lugar de tu artículo.
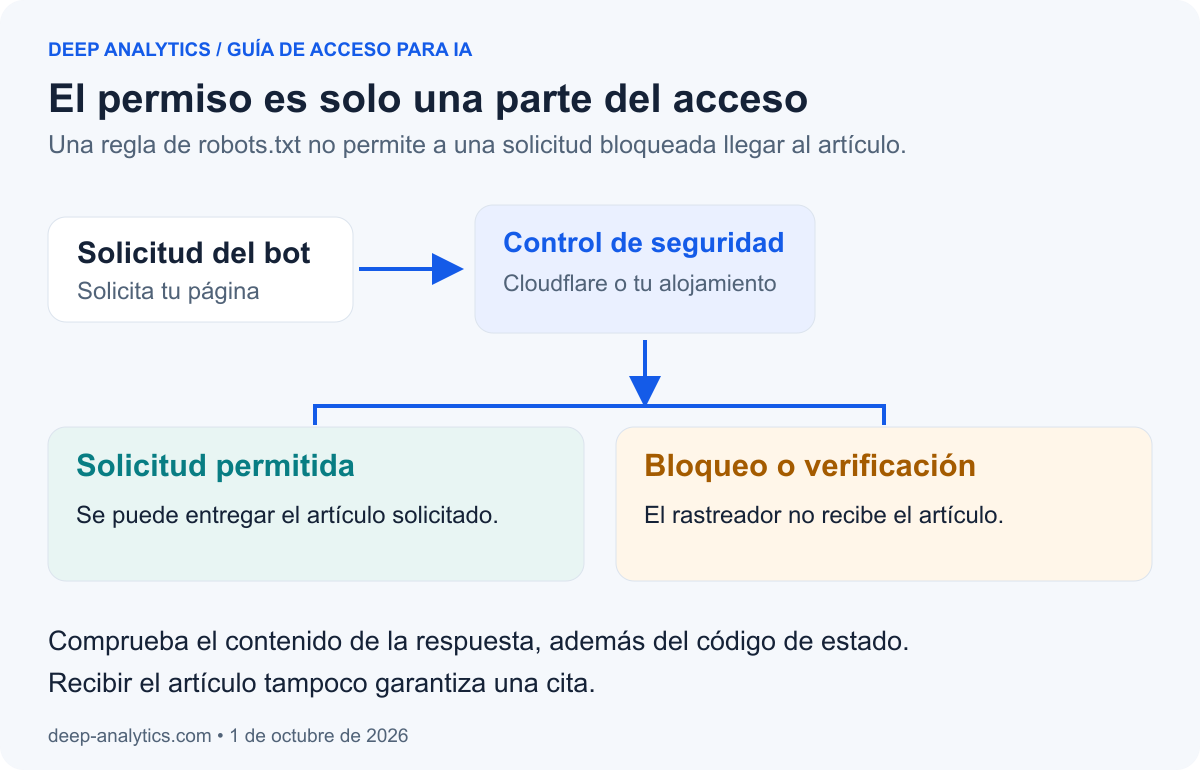
Los cambios de Cloudflare de septiembre de 2026 distinguen tres controles:
- Search: rastreo para construir un índice de búsqueda.
- Training: recopilación de contenido para desarrollar modelos.
- Agent: visitas en nombre de un usuario.
Con Disallow AI Training, Bot Preference Sync publica en robots.txt las preferencias de entrenamiento compatibles. Los rastreadores de uso mixto que cumplen los requisitos siguen permitidos para la búsqueda; los demás rastreadores de entrenamiento se bloquean activamente. Un rastreador de uso mixto sirve para más de un propósito.
Block también puede detener Googlebot, Bingbot y Applebot, lo que afecta al acceso para búsqueda. Cloudflare está sustituyendo controles anteriores, y los bloqueos previos de Training se migran a Disallow AI Training. Revisa también el ajuste resultante de Agent: algunas configuraciones migradas y el ajuste predefinido para sitios financiados con publicidad bloquean agentes en las páginas con anuncios.
La preferencia de entrenamiento de Microsoft a nivel de sitio mediante robots.txt sigue prevista para principios de 2027. Hasta que esté disponible, Disallow AI Training no comunica automáticamente esa preferencia a Bing mediante robots.txt; revisa por separado los controles de página o de cabecera de Microsoft.
Fuente: ajustes, tablas de migración y limitaciones por proveedor de Cloudflare.
Conclusión práctica: inspecciona tanto el robots.txt que realmente se entrega como las reglas de seguridad. Un estado HTTP correcto por sí solo no basta: una página de verificación no es el artículo que buscaba el rastreador.
7. Cómo comprobar el efecto real de tus ajustes
Empieza por una decisión de negocio: ¿qué usos ayudan a los clientes a encontrar y evaluar tu empresa, y cuáles quieres restringir? Después, realiza estas cinco comprobaciones.
- Documenta la política que quieres aplicar. Registra las decisiones sobre entrenamiento, búsquedas, grounding y acceso solicitado por usuarios para cada proveedor. Señala dónde los controles disponibles agrupan varios usos.
- Localiza todos los ajustes relevantes. Revisa robots.txt, las plantillas de las páginas, los paneles de los proveedores y las reglas de seguridad. Incluye los subdominios importantes y las versiones en distintos idiomas.
- Inspecciona lo que sirve la web. Comprueba el archivo robots.txt público y el HTML de las páginas. Un ajuste en un editor demuestra tu intención; la respuesta entregada muestra lo que puede recibir un rastreador.
- Verifica el acceso de rastreadores reales. Contrasta los registros del servidor o de seguridad con los rangos oficiales de IP o las comprobaciones DNS documentadas por el proveedor. Copiar el nombre de un agente de usuario solo sirve como prueba de diagnóstico: cualquier cliente puede atribuirse esa identificación.
- Mide los resultados por separado. Haz un seguimiento de los fallos de rastreo, la indexación, una muestra de citas en IA, las visitas de referencia y las consultas recibidas. Registra cuándo cambian los ajustes para poder investigar los resultados sin dar por hecho que la coincidencia temporal demuestra causalidad.
Concreta la comprobación de acceso
Para Perplexity, una excepción del cortafuegos debe exigir tanto el agente de usuario esperado como una IP de los rangos oficiales publicados. Mantén esos rangos actualizados y limita la excepción al acceso previsto para el bot. La guía de cortafuegos de Perplexity explica el procedimiento. OpenAI, Amazon, Apple y Common Crawl también documentan métodos de verificación en las páginas de proveedores enlazadas más arriba.
Utiliza los informes junto con tu analítica
Google ofrece un informe de rendimiento de IA generativa. Bing Webmaster Tools ofrece un informe AI Performance que cubre las citas en las experiencias compatibles de Microsoft y sus socios. Lee el alcance de cada informe; ninguno representa todas las respuestas de IA ni todas las interacciones con clientes.
Compara esas observaciones con las visitas de referencia y las consultas de clientes en tu propia analítica. Evita tratar un recuento de citas como si fuera un recuento de clics, o un cambio tras la publicación como prueba de causalidad.
Por ejemplo, una solicitud correcta demuestra que se entregó una página. Una cita demuestra que un servicio hizo referencia a ella en una respuesta observada. Una consulta de un cliente demuestra una respuesta comercial. Cada una responde a una pregunta distinta.
Para evaluar esas capas en conjunto, el Diagnóstico GEO de Deep Analytics aborda la visibilidad en búsquedas con IA y su medición. Empieza por la política deseada y después verifica qué entrega realmente la web.
Hay límites. Robots.txt comunica instrucciones a los rastreadores que las respetan; el contenido privado necesita autenticación y controles de acceso. Una exclusión actual tampoco demuestra que el contenido recopilado anteriormente se haya eliminado de un modelo ya entrenado. Consideraciones de seguridad del Protocolo de Exclusión de Robots
8. TL;DR
- ¿Puedes restringir el entrenamiento y mantener el acceso para búsquedas? A veces. OpenAI y Anthropic ofrecen opciones separadas para sus rastreadores; Apple ofrece un identificador de entrenamiento independiente. Revisa cada proveedor y los usos que agrupan sus controles.
- ¿Google? Revisa Google-Extended, el ajuste de inclusión en IA de Search Console y los controles de vista previa de cada página. Eliminar una página con
noindexsacrifica la visibilidad en búsquedas. - ¿NOARCHIVE o NOCACHE? NOARCHIVE de Microsoft también implica renunciar a la visibilidad en Chat/Copilot. NOCACHE permite una reutilización limitada para entrenamiento. Configura los metadatos de página o una cabecera de respuesta HTTP.
- ¿Utilizas Cloudflare? Disallow AI Training combina preferencias con bloqueos. Revisa los ajustes Search, Training y Agent, incluidas las opciones migradas.
- ¿Qué demuestra el éxito? Verifica el contenido entregado y después mide por separado la visibilidad y los resultados de negocio. La autorización por sí sola no garantiza citas ni ingresos.
Elige los usos que quieres permitir, entiende las contrapartidas y comprueba lo que entrega realmente tu web.