Demandez à un assistant IA de recommander un cabinet de conseil, d’expliquer un produit ou de comparer deux entreprises. La réponse peut sembler aller de soi. Des noms apparaissent, suivis de descriptions, et quelques sources donnent à l’ensemble un air rassurant de certitude.
Mais une question se cache derrière cette prose fluide : de quelle entreprise, de quelle personne ou de quel produit la réponse parle-t-elle réellement ?
Un nom familier ne suffit pas toujours. Deux entreprises peuvent porter le même. Un auteur peut apparaître sous différentes versions de son nom. Un service peut ressembler à un logiciel. Et un site web peut décrire les trois sans expliquer les liens qui les unissent.
C’est là que les entités deviennent utiles pour le GEO, ou Generative Engine Optimisation : le travail qui consiste à améliorer la manière dont votre contenu et votre entreprise apparaissent dans les réponses générées par l’IA.
L’intérêt n’est pas d’ajouter une nouvelle couche de jargon au SEO. Il est de rendre votre identité plus facile à établir, vos affirmations plus faciles à vérifier et vos relations plus faciles à suivre.
Voici ce que je souhaite examiner :
- Ce qu’est réellement une entité.
- Pourquoi les systèmes d’IA bénéficient d’identités claires.
- Ce qu’apportent Schema.org et JSON-LD.
- La place de Wikidata, et ses limites.
- Comment transformer tout cela en travail utile sur un vrai site web.
1. Une entité est une chose précise, pas seulement une expression
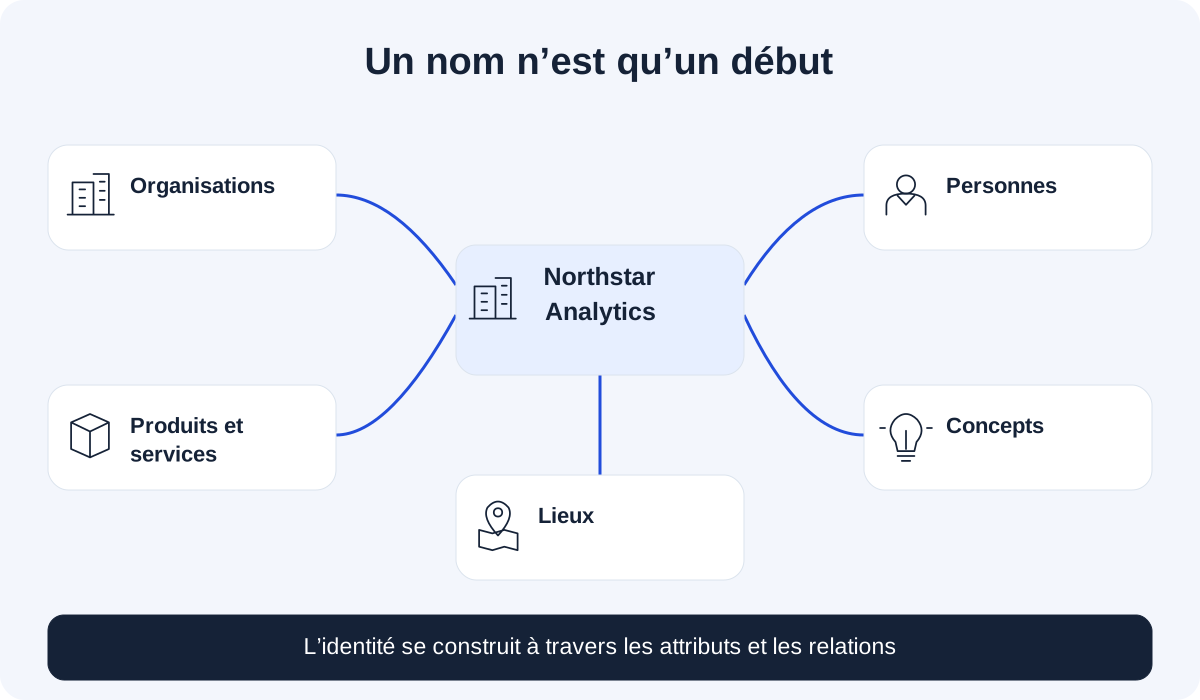
Considérez une entité comme quelque chose que vous pouvez identifier de manière distincte et décrire à travers des attributs et des relations.
Une organisation a un nom, un site web et peut-être une implantation. Une personne a une fonction professionnelle et des affiliations. Un produit a un fabricant et des caractéristiques. Un lieu a une localisation. Un concept a un sens et des liens avec d’autres concepts.
Ce sont les cinq familles illustrées dans la diapositive de conférence qui a inspiré cet article : les organisations, les personnes, les produits, les concepts et les lieux. Les services ont eux aussi leur place, même si leur description doit refléter ce qu’ils sont réellement.
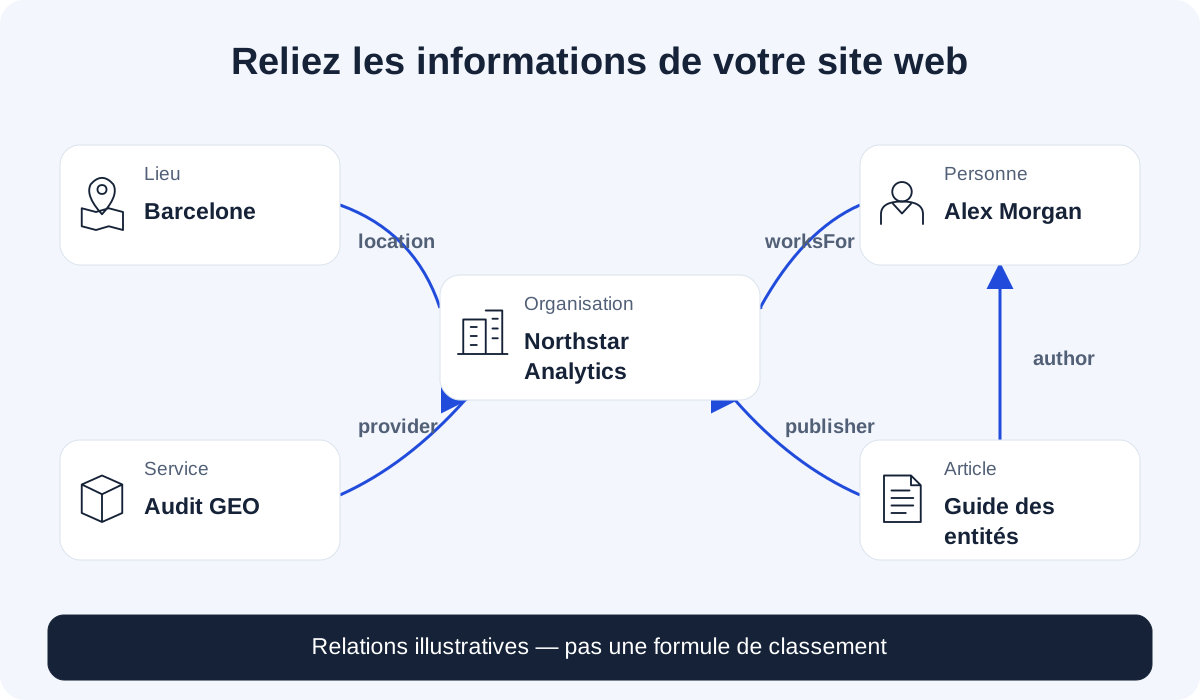
Prenons un cabinet de conseil fictif appelé Northstar Analytics. Son fondateur, Alex Morgan, est une entité. Le cabinet en est une autre. Son service d’audit GEO en est une troisième. Barcelone, où il est établi, en est encore une autre.
Vous pouvez placer ces noms sur une page. Ou vous pouvez expliquer leurs relations : Alex travaille pour Northstar ; Northstar propose l’audit ; l’entreprise est établie à Barcelone.
La seconde version en dit beaucoup plus au lecteur. Elle fournit aussi des éléments plus clairs à un système qui cherche à relier les faits.
Cette distinction compte lorsque l’on passe de la correspondance entre des mots à l’identification de ce qu’ils désignent.
2. Pourquoi cela compte lorsque la réponse est générée
Une réponse de l’IA au sujet d’une entreprise doit identifier correctement son sujet. Si elle confond deux entreprises portant le même nom, même une explication élégante devient peu fiable.
La difficulté, c’est que « l’IA » se résume rarement à un seul mécanisme simple. Selon le produit et la requête, une réponse peut s’appuyer sur les connaissances du modèle, des pages récupérées, des résultats de recherche ou d’autres informations connectées. Ces voies ne traitent pas toutes les sites web de la même manière.
Les LLM peuvent reconnaître des entités nommées dans un texte ordinaire, comme le montrent les travaux sur la reconnaissance d’entités nommées. Reconnaître un nom et déterminer à quelle entité du monde réel il renvoie sont deux tâches différentes. Un modèle n’a pas systématiquement besoin d’une entrée Wikidata ou d’un bloc JSON-LD pour reconnaître une entreprise. Prétendre le contraire reviendrait à exagérer les capacités de cette technologie.
La conclusion pratique que j’en tire est plus limitée : une identité et des relations explicites réduisent l’ambiguïté des éléments disponibles pour ces systèmes. Il reste à vérifier si un produit donné utilise ces éléments et si la réponse obtenue s’améliore.
Sur le site de Northstar, « nous aidons les marques ambitieuses à réussir » laisse sans réponse la plupart des questions utiles. « Northstar Analytics est un cabinet de conseil établi à Barcelone qui propose des services d’analytics et des audits GEO » donne aux lecteurs comme aux machines des informations plus concrètes.
Le même principe s’applique à une page d’auteur. Donnez à Alex une véritable biographie, une fonction définie et des liens vers ses travaux. Un nom sous un article est un début ; une identité professionnelle reliée à d’autres informations est plus instructive.
Il y a aussi un bénéfice éditorial. Décrire clairement l’entité révèle souvent le positionnement flou qui se cachait derrière le langage marketing.
Imaginez une question comparative : « Quels cabinets de conseil à Barcelone proposent des audits GEO, et qui dirige ces missions ? » Une page qui relie clairement l’organisation, le service, la localisation et l’expert contient les éléments nécessaires à une réponse pertinente. Une page contenant ces quatre mots quelque part dans son texte peut encore laisser leurs relations dans le flou. Cela ne garantit pas qu’elle sera retenue, mais explique pourquoi le travail sur les entités est utile avant même de commencer à le mesurer.
3. Schema.org fournit le vocabulaire. JSON-LD le véhicule
Ces deux noms sont souvent associés, mais ils remplissent des fonctions différentes.
Schema.org fournit des termes communs pour décrire les choses et leurs relations : Organization, Person, Service, Article, author, publisher et bien d’autres. JSON-LD est un format permettant d’exprimer des données liées, généralement placé sur une page web dans un bloc de script. L’introduction de Schema.org et la norme JSON-LD du W3C expliquent cette distinction.
Vous rendez le sens plus explicite. Ceci est une organisation. Cette personne travaille pour elle. Cette organisation fournit ce service.
Il existe ici un usage documenté pour la recherche : Google indique que les données structurées l’aident à comprendre le contenu d’une page, et sa documentation sur les organisations décrit expressément la désambiguïsation des entreprises. Cela étaye l’intérêt d’une identité plus claire ; cela ne démontre pas une augmentation universelle des citations par l’IA. L’introduction de Google aux données structurées et ses recommandations sur les organisations.
Pour Northstar, un petit graphe JSON-LD pourrait ressembler à ceci :
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "Organization",
      "@id": "https://northstar.example/#organisation",
      "name": "Northstar Analytics",
      "url": "https://northstar.example/"
    },
    {
      "@type": "Person",
      "@id": "https://northstar.example/team/alex/#person",
      "name": "Alex Morgan",
      "worksFor": {
        "@id": "https://northstar.example/#organisation"
      }
    }
  ]
}
Exemple fictif utilisant un domaine réservé aux exemples ; adaptez-le aux faits décrits de manière visible sur la page concernée.
L’organisation reçoit un @id stable. La personne renvoie à cet identifiant à travers worksFor. Les deux descriptions sont reliées au lieu de rester isolées. Un @graph peut regrouper les nœuds, tandis que les identifiants leur permettent de se référencer mutuellement. Le W3C sur les identifiants de nœuds.
Utilisez systématiquement le même identifiant d’organisation lorsque d’autres pages renvoient à cette entreprise. Un service peut être relié par provider ; un article, par author et publisher. Choisissez le type qui décrit le sujet, plutôt que celui qui semble le plus à la mode.
4. Wikidata donne à certaines entités une identité publique partagée
Votre site web peut décrire votre entreprise. Wikidata propose autre chose : une base de connaissances publique et collaborative dans laquelle une entité peut posséder un identifiant commun à plusieurs langues et descriptions.
Les éléments utilisent des identifiants commençant par Q. Par exemple, Q312 identifie Apple Inc., et non le fruit ou une autre entreprise appelée Apple.
Des libellés, des alias, des descriptions et des déclarations sont associés à cet identifiant. Des libellés dans différentes langues peuvent renvoyer au même élément, ce qui est utile lorsqu’un nom varie d’un marché à l’autre. Wikidata enregistre aussi des références et des liens vers d’autres bases de données. L’introduction de Wikidata.
Cela en fait une référence d’identité utile lorsque l’élément est exact et décrit bien l’entité en question. Cela ne signifie pas que chaque assistant IA consulte Wikidata pour chaque réponse, ni qu’un élément entraîne automatiquement la recommandation de son sujet.
Pour un site multilingue, cette distinction est particulièrement concrète. Une page en anglais et une page en espagnol peuvent décrire la même organisation avec des formulations différentes tout en conservant la même référence d’identité. Des traductions exactes et des faits cohérents restent nécessaires. L’identifiant aide à dire « il s’agit du même sujet » ; il ne traduit pas le contenu et ne démontre pas que les affirmations qui l’entourent sont vraies.
Une autre limite mérite davantage d’attention : Wikidata est un projet communautaire de connaissances, pas un annuaire promotionnel d’entreprises.
Une entité n’a pas nécessairement besoin d’un article Wikipédia pour être admissible. La politique de notoriété autorise aussi des critères fondés sur des références publiques sérieuses ou sur un besoin structurel. Mais l’admissibilité doit être évaluée selon ces règles ; vouloir davantage de visibilité GEO ne donne pas droit à un élément. La politique de notoriété de Wikidata.
Pour un petit cabinet de conseil, le point de départ raisonnable peut simplement être un site clair, des profils professionnels exacts et une couverture externe crédible. Si un élément Wikidata approprié existe déjà, vérifiez-le. S’il n’en existe pas, déterminez si sa création sert la base de connaissances avant de réfléchir aux bénéfices marketing. Les propres recommandations de Wikidata mettent en garde contre la création d’éléments à des fins promotionnelles. L’aide sur les éléments.
5. Un identifiant local et sameAs ne sont pas interchangeables
C’est une petite distinction technique aux conséquences pratiques importantes.
Votre @id identifie un nœud dans les données de votre site web. Un lien sameAs pointe vers une autre page qui identifie sans ambiguïté la même chose. Schema.org inclut expressément les entrées Wikidata parmi ses exemples. La définition de sameAs.
Si vous décriviez Apple Inc., l’URL Wikidata vérifiée de Q312 pourrait servir de référence d’identité. Elle ne conviendrait pas à Northstar Analytics au seul motif que le cabinet travaille avec des produits Apple.
De même, un article sur le GEO n’est pas la même entité que le concept de GEO. Un fondateur n’est pas la même entité que son entreprise. Une association ne rend pas deux choses identiques.
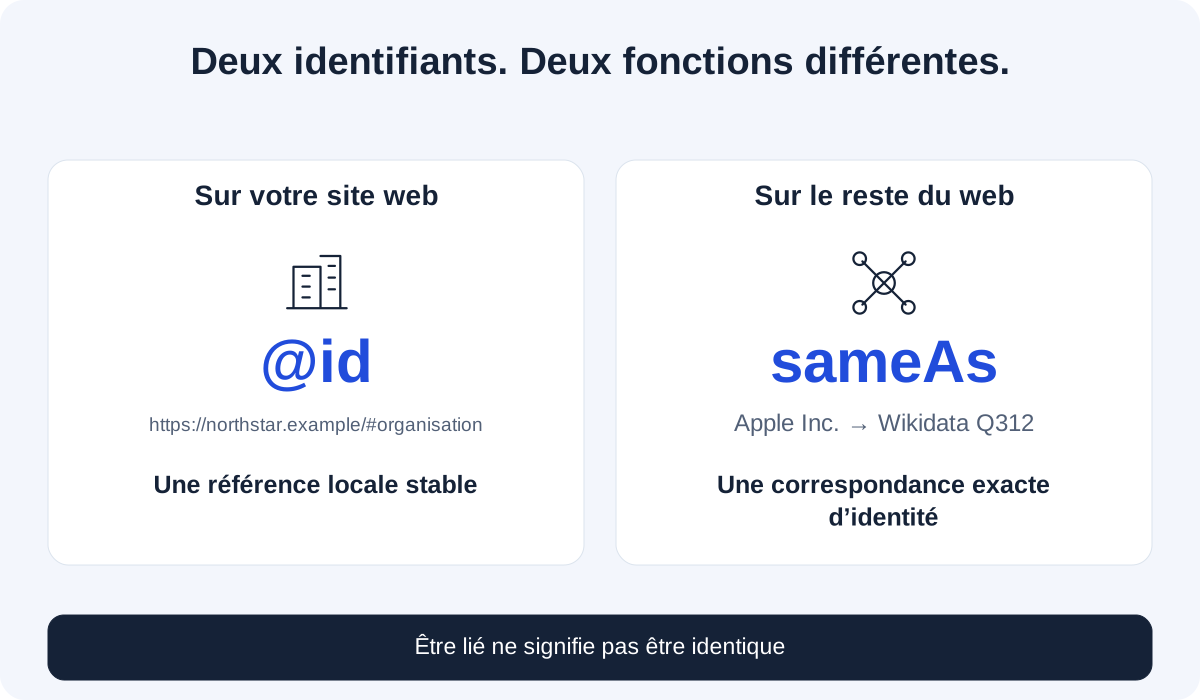
Utilisez une relation adaptée à l’affirmation : author pour indiquer l’auteur, worksFor pour la relation d’emploi ou about pour le sujet d’une œuvre. Réservez sameAs à l’identité.
La même prudence s’applique aux noms. Une dénomination légale, un nom commercial et un nom de marque traduit peuvent légitimement différer. Expliquez leurs liens au lieu d’imposer une correspondance caractère par caractère à chaque libellé.
Un bloc techniquement valide peut tout de même décrire la mauvaise entreprise. Réussir la validation vous renseigne sur le code ; cela ne certifie pas la véracité de chaque déclaration qu’il contient.
6. Ce que je changerais concrètement sur un site web
Je commencerais par les pages visibles.
Un visiteur peut-il comprendre à qui appartient le site, ce que propose l’entreprise, qui rédige son contenu et où elle exerce son activité ? Les principaux services sont-ils décrits individuellement ? Les biographies des auteurs expliquent-elles leur expérience pertinente sans l’exagérer ?
Ensuite, je cartographierais un petit ensemble d’entités et de relations. Pour Northstar, cela signifie l’organisation, les personnes concernées, les services, les articles et la localisation. Il n’est pas nécessaire de baliser chaque substantif sur chaque page.
Vient ensuite la mise en œuvre : des identifiants stables, des types et des propriétés appropriés, et des références qui relient les bons nœuds. Vérifiez les extensions existantes avant d’ajouter un autre bloc ; deux outils peuvent facilement publier des descriptions contradictoires de la même entreprise.
Le balisage doit rester fidèle au contenu visible. Ne l’utilisez pas pour glisser des compétences, des récompenses, des avis ou des affiliations que la page ne peut pas étayer. Les règles de Google exigent que les données structurées représentent fidèlement la page. Les consignes relatives aux données structurées.
Regardez ensuite au-delà du site web. Corrigez les profils obsolètes, clarifiez les descriptions ambiguës et recherchez des preuves crédibles à l’appui des affirmations que vous souhaitez voir reprises. Répéter votre propre affirmation sur dix profils n’équivaut pas à une corroboration indépendante.
Enfin, vérifiez l’accès et mesurez le résultat. Les robots d’exploration pertinents peuvent-ils accéder aux pages ? Le contenu peut-il être récupéré ? Lorsque vous testez des questions, la réponse identifie-t-elle la bonne entreprise et lui attribue-t-elle les bons services et les bonnes personnes ?
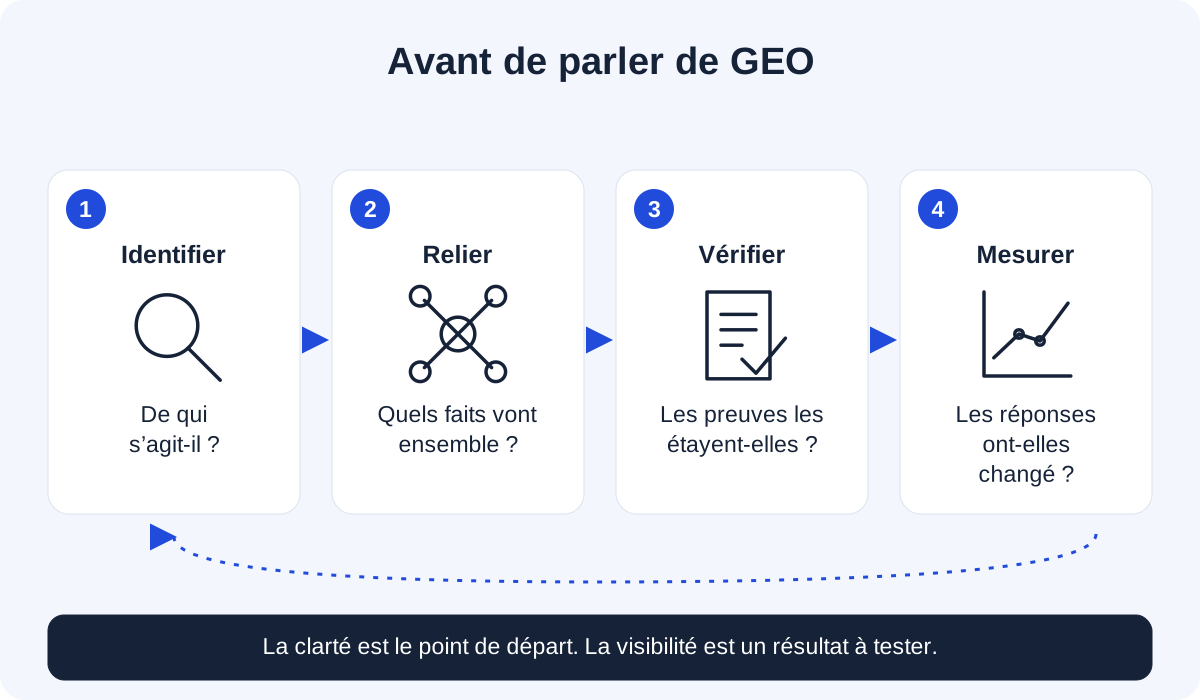
Suivez séparément les mentions, les citations accompagnées de liens et l’exactitude factuelle. Une marque peut être nommée sans être citée, ou citée avec une description incorrecte. Consignez les prompts, la langue, la plateforme, la date et les requêtes ayant échoué pour disposer d’une référence de comparaison pertinente.
Un changement dans un petit échantillon de test est une observation, pas une preuve de visibilité globale sur le marché ni d’un effet causal de JSON-LD. D’autres changements dans le contenu, la récupération d’informations et la plateforme elle-même peuvent influer sur le résultat.
7. Mon point de vue sur la promesse du GEO
Je pense que le travail sur les entités mérite sa place lorsqu’il rend une entreprise plus facile à comprendre et ses informations plus faciles à maintenir.
C’est une raison solide d’y investir. L’argument moins convaincant consiste à affirmer que l’ajout d’un balisage schema et d’un identifiant Wikidata ouvre l’accès à un système de recommandation par l’IA.
Google est particulièrement clair sur ce point pour ses propres fonctionnalités de recherche avec l’IA : aucun balisage Schema.org spécial n’est requis pour y apparaître. Ses recommandations continuent de mettre l’accent sur les fondamentaux établis du SEO et sur un contenu utile et accessible. Cette déclaration concerne les fonctionnalités de Google, pas tous les produits d’IA. Les recommandations de Google sur ses fonctionnalités d’IA.
Wikidata peut fournir une référence publique précieuse. Schema.org en JSON-LD peut exprimer une description cohérente sur votre site. Aucun des deux ne crée une expertise, des preuves indépendantes ou une réponse utile lorsque ces éléments manquent.
Je formulerais donc l’ambition ainsi : faciliter l’identification de la bonne entité, la compréhension de ce qu’elle fait et la vérification des raisons pour lesquelles elle a sa place dans la réponse. Puis tester si les systèmes qui vous intéressent utilisent réellement ces informations.
C’est moins spectaculaire qu’un raccourci GEO garanti. C’est aussi une base de travail beaucoup plus défendable.
TL;DR : les points clés
- La réponse pourrait-elle vous confondre avec quelqu’un d’autre ? Clarifiez l’entité à travers ses noms, ses attributs et ses relations.
- Vos données structurées décrivent-elles les faits visibles ? Reliez les bons nœuds avec des identifiants stables et des propriétés appropriées.
- Wikidata est-il la bonne référence ? Utilisez un élément exact et vérifié lorsque c’est pertinent ; évaluez l’admissibilité avant toute création.
- La visibilité s’est-elle améliorée ? Testez les mentions, les citations et l’exactitude au lieu de considérer un balisage valide comme le résultat.